我们给 Go 服务限了 CPU,P99 反而涨了 3 倍
给容器加一条再正常不过的 CPU 限制,尾延迟不降反升,涨了 3 倍。这一篇讲清楚它为什么会这样,以及我当时是怎么一步步想错的。
一次再常规不过的操作:给一个 Go 写的微服务,在 k8s 上加一条 CPU limit——4 核封顶。理由很正当:别让它在宿主机上没节制地抢 CPU,影响同一台机器上的邻居。改完 YAML,上线,盯监控。
吞吐量掉了一点,在预期之内——毕竟设了上限。可就在我准备关掉面板的时候,P99 延迟那条线,从平时的 30 毫秒,一路窜到了 90 毫秒。限了 CPU,尾延迟不降反升,还翻了三倍。
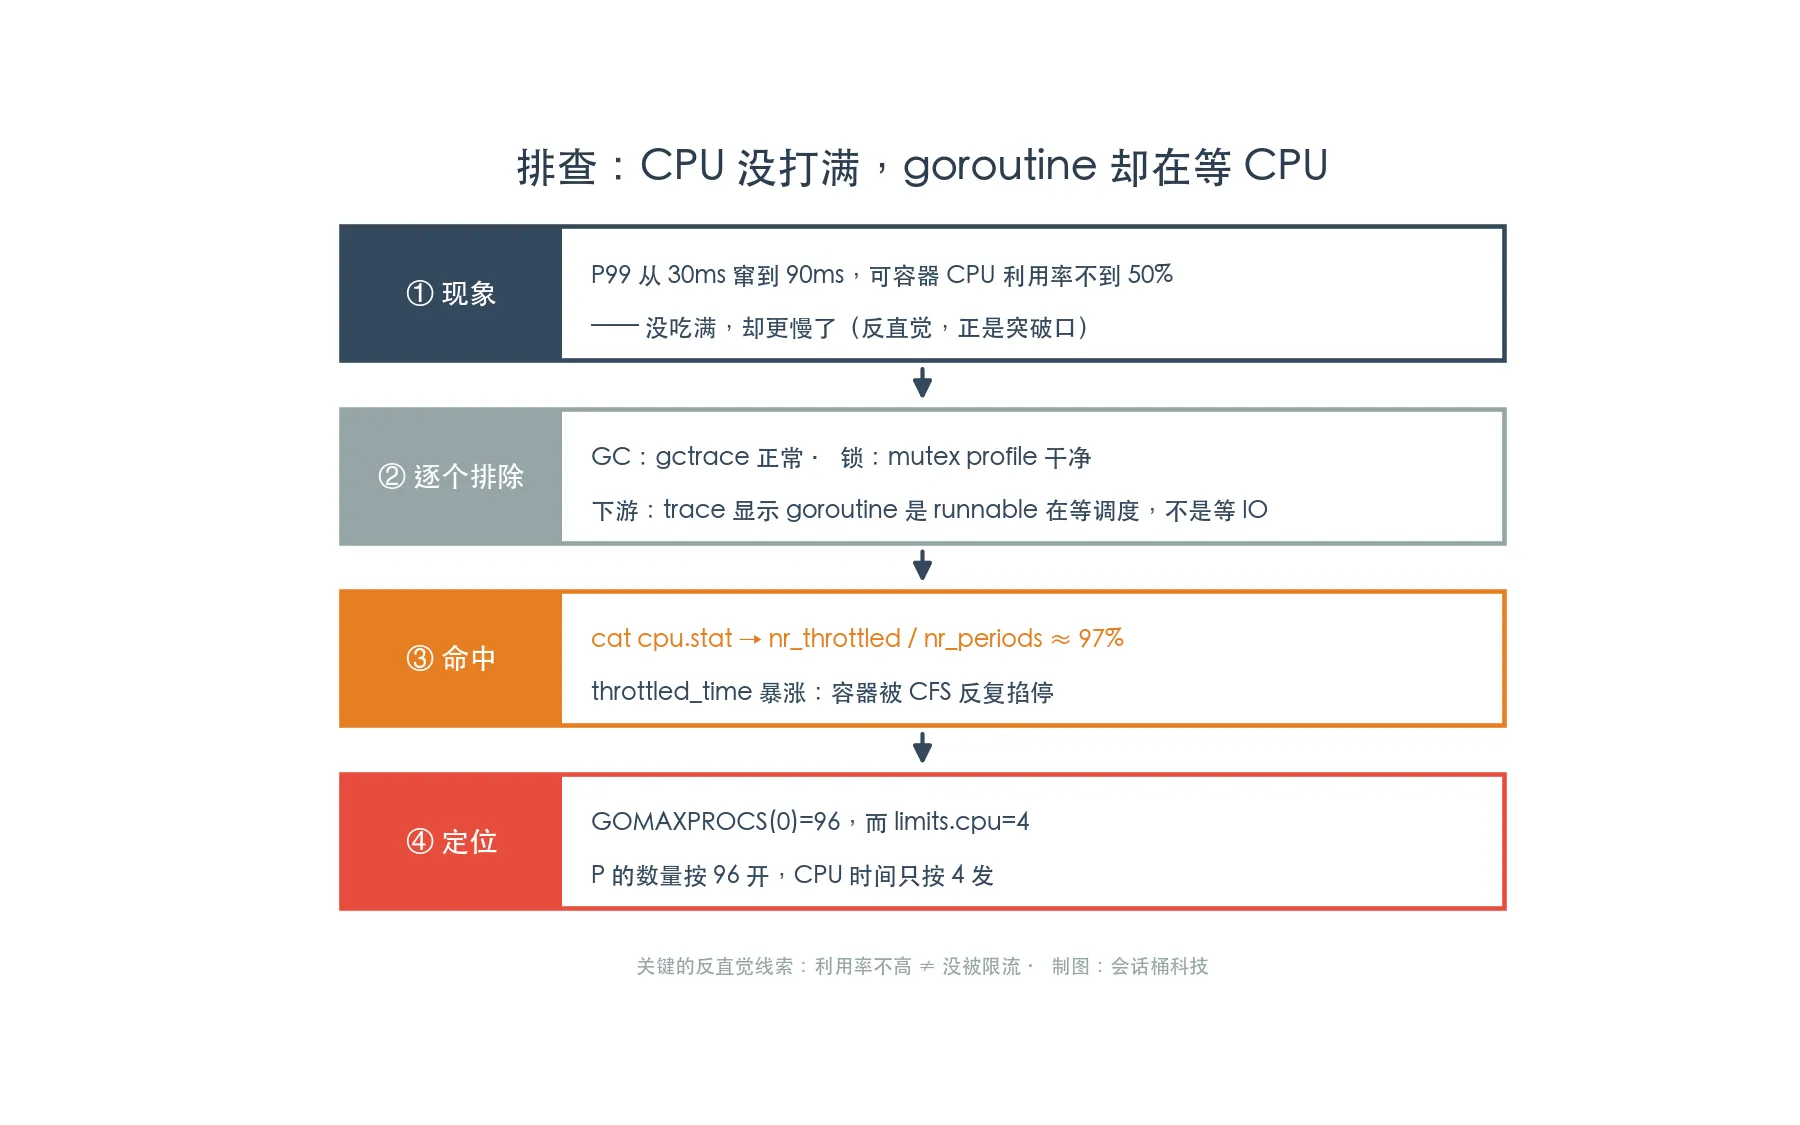
更说不通的是隔壁那张图:这个容器的 CPU 利用率,平均连 50% 都不到。没吃满,却更慢了。 一个只用了一半 CPU 的服务,凭什么比不限制的时候还卡?
这事儿卡了我大半天。最后发现,根子不在我的代码里,而在 Go 运行时和 Linux cgroup 之间一个错位的假设上——一个几乎每个把 Go 服务塞进容器的人都会踩、却很少有人第一时间想到的坑。
一、我最先怀疑的三个方向,全错了
现象摆在那儿:尾延迟尖刺 + CPU 没打满。这俩凑一块,我的第一反应是——“延迟尖刺,八成是 GC 在偷偷 STW。”
Go 的垃圾回收虽然号称亚毫秒级 STW,但真遇上尾延迟问题,老手的肌肉记忆就是先看 GC。我把 GODEBUG=gctrace=1 打开,盯着日志刷:GC 频率没有异常飙升,单次 STW 大多在几百微秒,偶尔冒个几毫秒的尖峰,但远远撑不起“30 毫秒变 90 毫秒”这个量级。GC 有嫌疑,但不是主犯。
第二个念头:锁竞争。 是不是某条热点路径上有把 mutex,并发一上来就排队?我抓了 mutex profile 和 block profile,go tool pprof 看下来,竞争最凶的那把锁,累计等待时间也不够看。这条也断了。
第三个,也是最容易甩锅的一个:“是不是下游慢了?” 数据库、Redis、下游 RPC——尾延迟一高,大家习惯性先怀疑是不是被依赖拖累。我拉了一段 runtime/trace,想看看那些慢请求到底卡在哪一步。
结果 trace 给了我第一个真正有用的线索,也顺手扇了我一巴掌:那些慢下来的 goroutine,既不是在等锁,也不是在等网络 IO——它们处于 runnable 状态。 翻译成人话就是:活儿早就准备好了、随时能跑,但它们在运行队列里排着,迟迟没被调度到 CPU 上去执行。
不是没活干,是有活干、却没 CPU 给它干。可监控明明说 CPU 才用了一半啊?
到这一步我才反应过来:我一直盯着的那个“CPU 利用率 50%”,本身可能就是个骗人的数字。
二、真正的线索,藏在一个平时没人看的文件里
既然 goroutine 是“能跑但没得跑”,那问题就不在 Go 这一侧,而在它下面那一层——操作系统到底给不给它 CPU。
在容器里,管这件事的是 cgroup。我 exec 进容器,cat 了一个平时根本不会去翻的文件:
$ cat /sys/fs/cgroup/cpu/cpu.stat
nr_periods     1088234
nr_throttled   1052991
throttled_time 74215600000000
(cgroup v2 的路径和字段名略有不同,大意一样。)
nr_throttled 除以 nr_periods,约等于 97%。翻译成人话:CFS 调度器统计的每一个 100 毫秒周期里,有 97% 的周期,这个容器都被掐停(throttle)过。throttled_time 是累计被冻结的纳秒数,大得吓人。
这就对上了。所谓“CPU 利用率只有 50%”,是在“被允许运行的时间”里算出来的平均值——它没算上那些被 CFS 直接冻住、根本没资格运行的时间。容器不是不想用 CPU,是被按住了,不让用。
那还剩最后一个问题:我明明给了 4 核,为什么会被掐得这么惨?我在服务启动时补了一行日志:
log.Printf("GOMAXPROCS=%d  NumCPU=%d",
    runtime.GOMAXPROCS(0), runtime.NumCPU())
// 输出:GOMAXPROCS=96  NumCPU=96
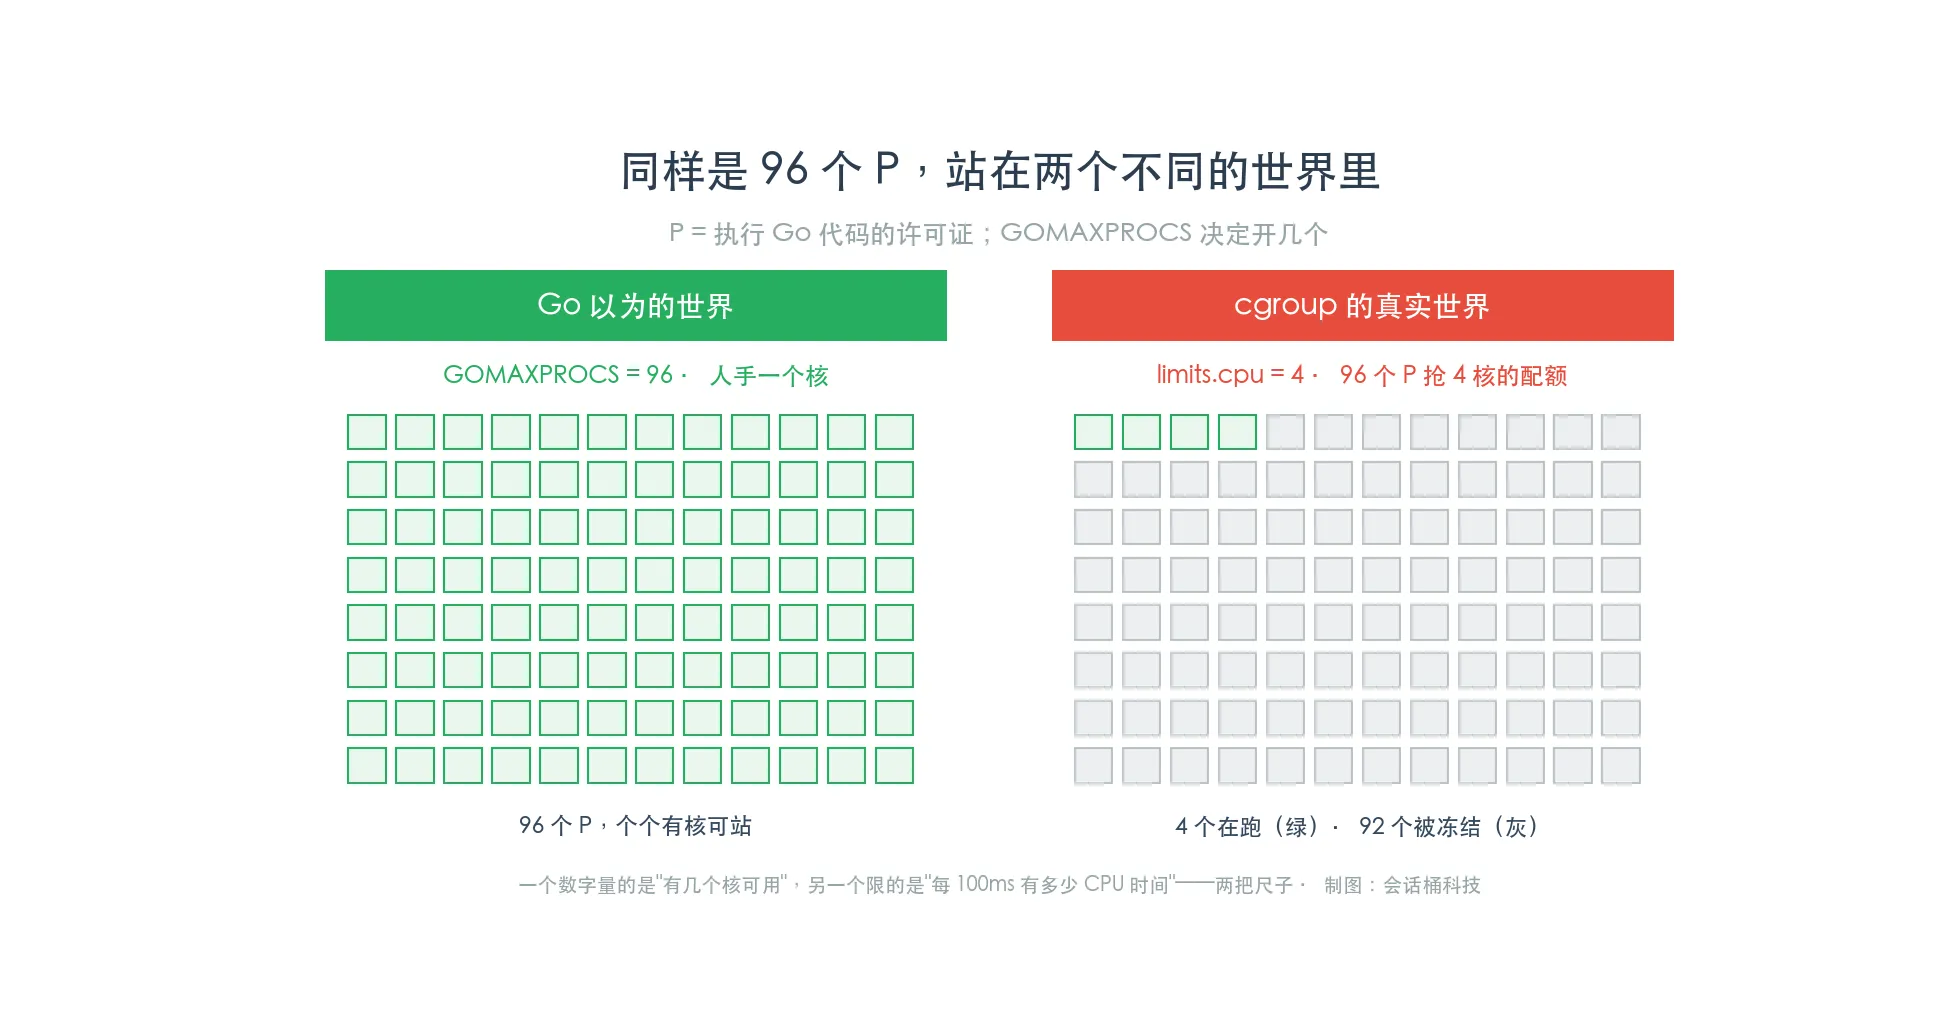
宿主机是一台 96 核的大机器。我限了 4 核,Go 却按 96 核在跑。 错位就在这儿。
三、根因:两把尺子,量的根本不是同一样东西
要讲清楚这个 96 和 4 为什么会打架,得先说 Go 运行时是怎么理解“我有几个 CPU”的。
Go 的调度模型是 G-P-M 三层:G 是 goroutine,M 是操作系统线程,而 P(Processor)是“执行 Go 代码的许可证”——有多少个 P,就最多允许多少个线程同时在跑 Go 代码。 P 的数量,就是 GOMAXPROCS。
GOMAXPROCS 默认等于 runtime.NumCPU()。而 NumCPU() 在 Linux 上,读的是进程的 CPU 亲和性(affinity)——也就是“我被允许调度到哪几个核上”。关键就在这里:限制 CPU,有两种完全不同的方式。
一种是 cpuset,绑核:明确告诉内核“你只能用 0~3 号这 4 个核”。这种方式会真的改掉进程的 affinity,NumCPU() 能读到,Go 会老老实实开 4 个 P。
另一种,也是 k8s limits.cpu、Docker --cpus 默认走的那种,是 CFS 带宽限制(quota):它不绑核,而是发“时间配额”——“每 100 毫秒,你这个容器所有线程加起来,最多用 400 毫秒的 CPU 时间(4 核 × 100 毫秒)”。注意:它压根没动 affinity。 容器里的进程放眼望去,依然看得见宿主机全部 96 个核,NumCPU() 于是理直气壮地返回 96。
两把尺子:Go 问的是“我能站在几个核上”(affinity,答案 96),你给的限制却是“我每 100 毫秒能花多少 CPU 时间”(quota,答案只有 4 核的量)。 问的和答的,根本不是同一个维度。于是 Go 开了 96 个 P,起了一大批线程,信心满满地要 96 路并行。
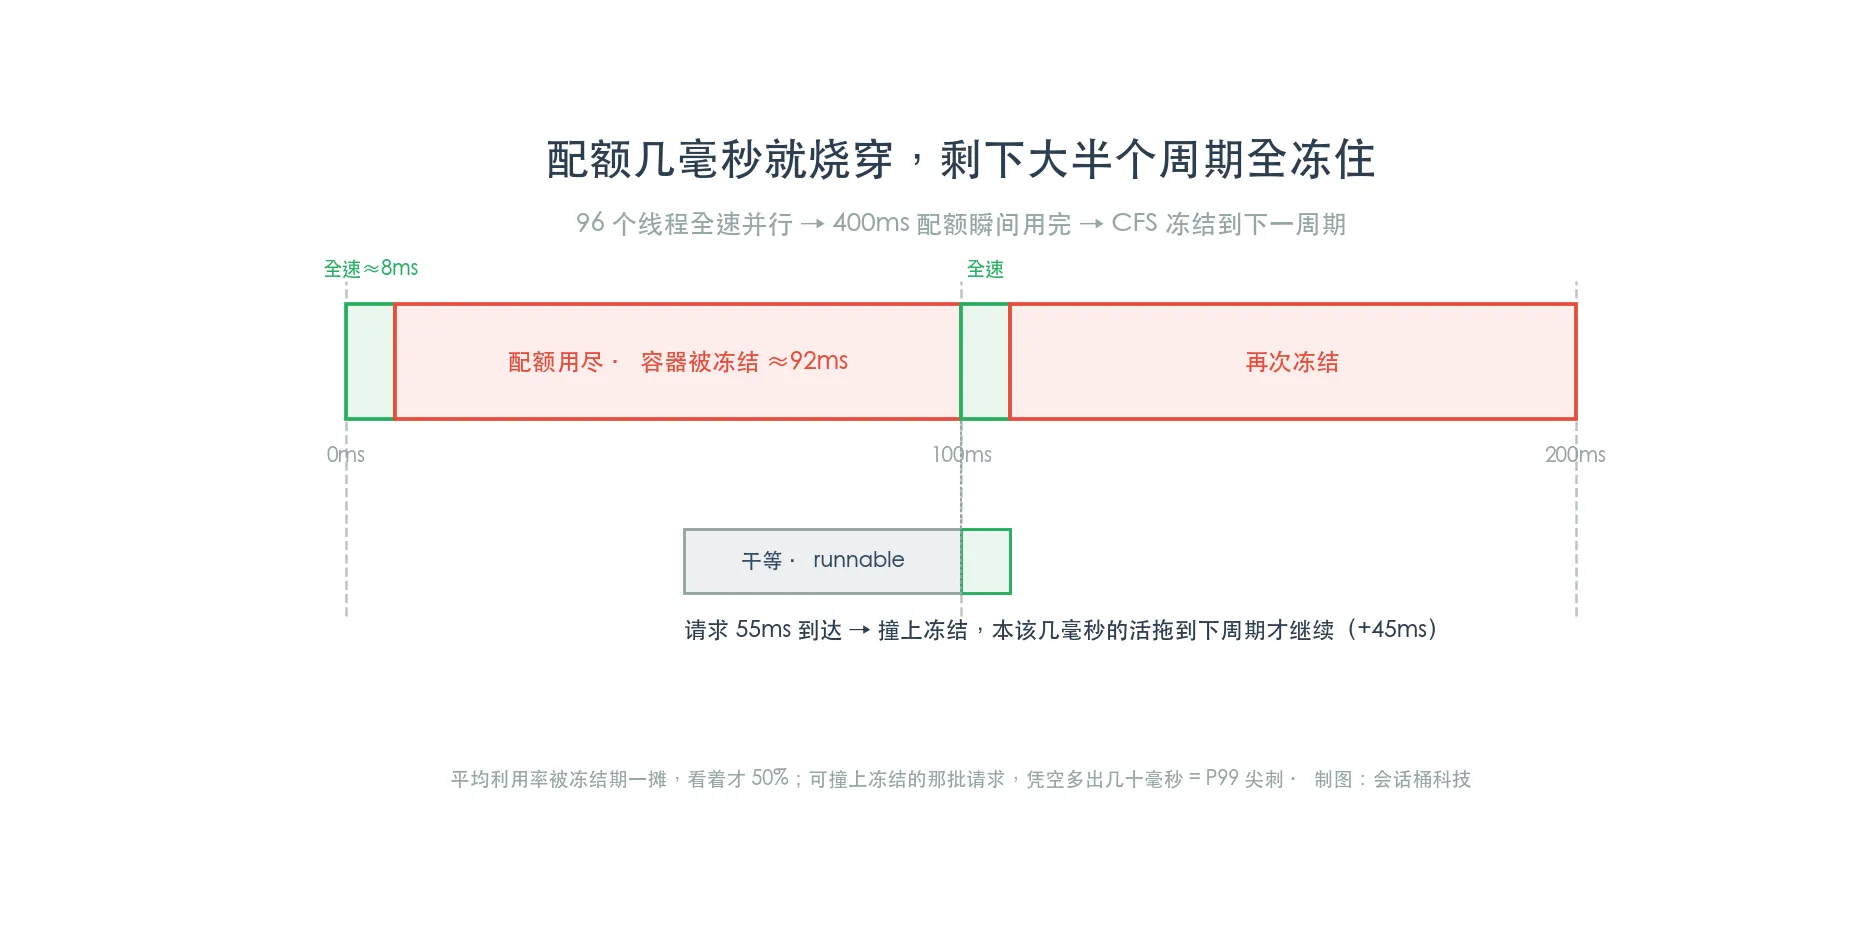
接下来就是灾难的引爆。因为没有 affinity 限制,这 96 个线程是真的能同时铺到宿主机 96 个核上跑的。它们一起全速冲刺,几毫秒之内就把整个 100 毫秒周期的 400 毫秒配额烧了个精光。配额一空,CFS 毫不留情:把这个容器的所有线程全部冻结,直到下一个周期开始。
于是一个 100 毫秒的周期,可能前 4、5 毫秒在狂奔,后面 90 多毫秒集体躺平。如果一个用户请求,恰好在这段冻结期里处理到一半——它就只能干等着,等下一个周期解冻才能继续。 一等,就是几十毫秒。平均 CPU 利用率被这么一平摊,看着不高;可对那些不幸撞上冻结窗口的请求来说,凭空多出来的这几十毫秒,就是 P99 那根尖刺的来源。
GC 还会火上浇油:Go 的后台标记 worker 数量大致按 GOMAXPROCS 的四分之一来配,96 个 P 就意味着约 24 个 GC worker,它们同样要挤那 4 核的配额;而每次 STW 又得协调停下全部 96 个 P。P 越多,这套协调本身的开销越大——不干活的 P,不是免费的。
说到底,GOMAXPROCS=96 这个数,让 Go 运行时活在一个“我有 96 个核”的幻觉里做所有决策:开多少线程、配多少 GC worker、怎么在 P 之间偷任务——每一项都是按 96 核的排场铺开的,而脚底下,只有 4 核的配额在硬扛。
四、怎么修的,以及我为此放弃了什么
修法出奇地简单:让 GOMAXPROCS 和 CPU limit 对齐。 只要 P 的数量降到 4,最多就只有 4 个线程同时在跑 Go 代码,它们把那 400 毫秒配额均匀摊到整个 100 毫秒周期里花——刚好用得完、又不会提前烧穿,CFS 就没有理由来掐你。throttle 消失,尾延迟立刻塌回 30 毫秒。
具体三种做法,按优先级:
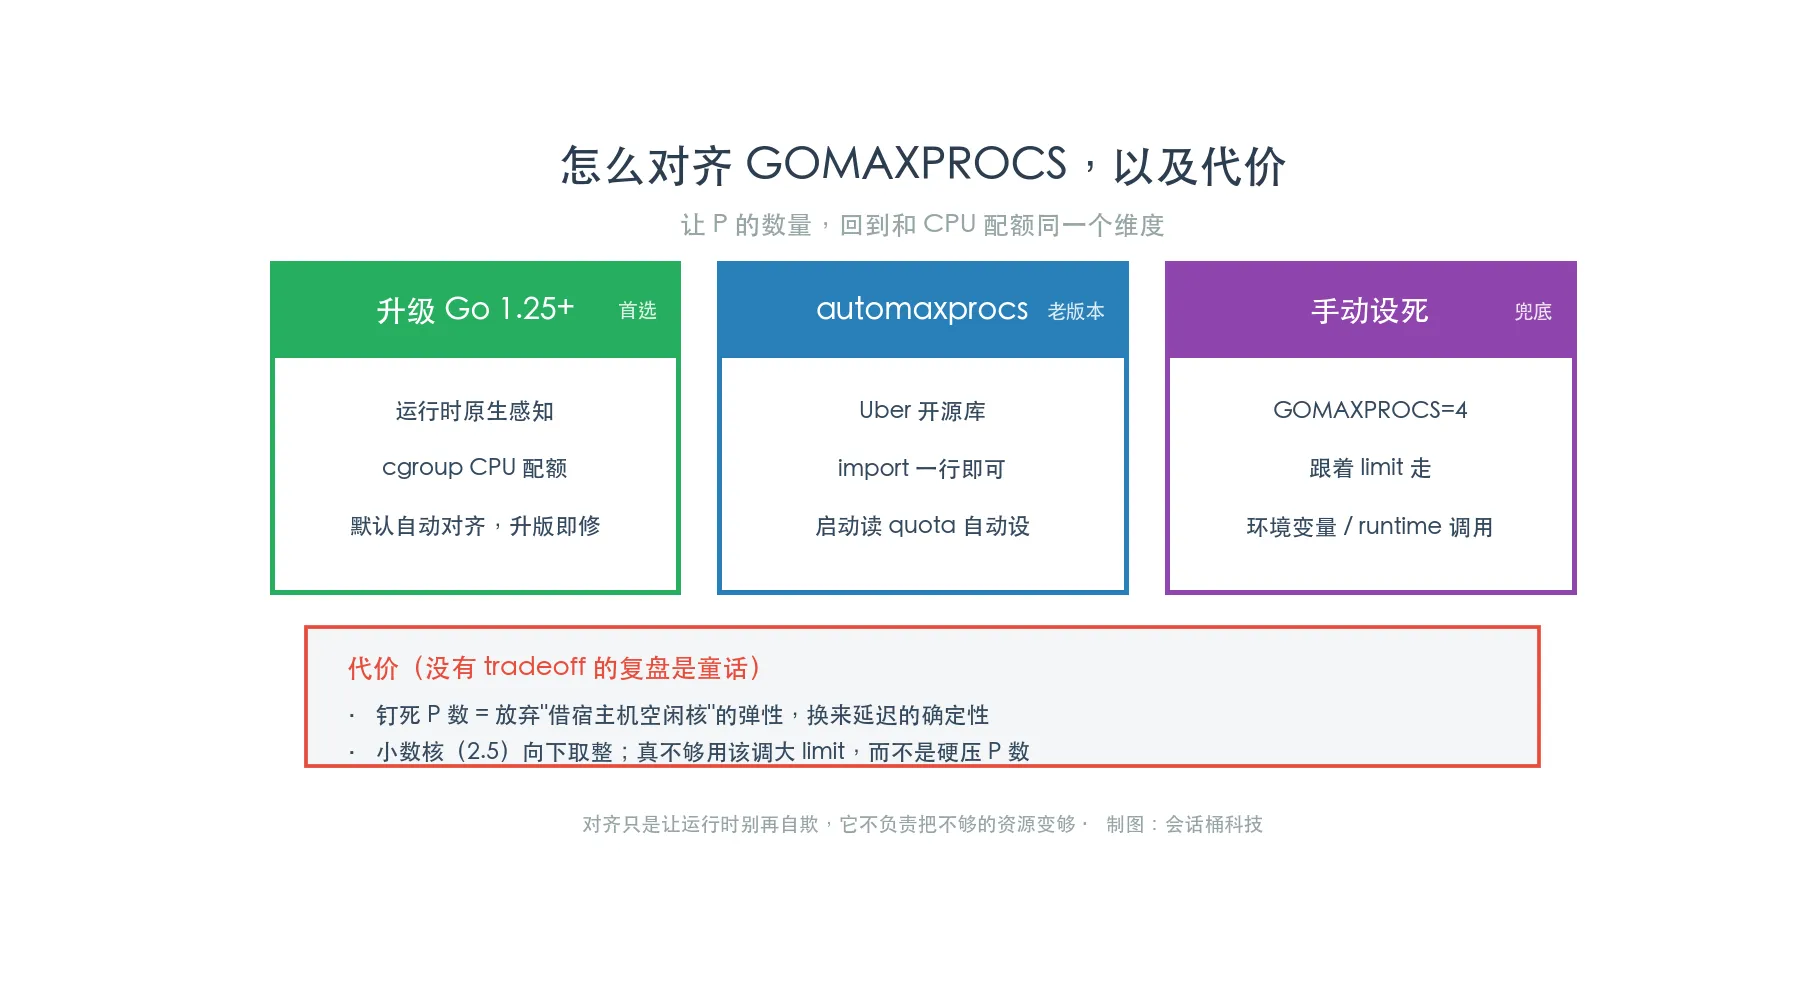
- 升级到 Go 1.25 及以上。 从 1.25 起,Go 运行时原生能感知 cgroup 的 CPU 配额,默认就会把 GOMAXPROCS 设成和 limit 匹配的值。升个版本,这个坑自动就填了。
- 老版本,用
go.uber.org/automaxprocs。 Uber 早年被同一个坑教育之后开源的库,import一行,进程启动时它去读 cgroup 的 quota,自动把 GOMAXPROCS 设对。零侵入。 - 实在不行,手动设。 启动时塞个环境变量
GOMAXPROCS=4,或者代码里runtime.GOMAXPROCS(4),跟着你的 limit 走。
但真正想聊的是代价——没有 tradeoff 的复盘都是童话。
把 GOMAXPROCS 钉死在 4,意味着你主动放弃了“偷用宿主机空闲核”的可能。在某些配置下(比如 quota 给得比日常需求宽,或用的是 CPU shares 这种软限制),一个开了更多 P 的进程,遇到突发流量时,是有机会短暂借到更多并行度、把这批活更快冲完的。钉成 4,就等于把这条弹性通道焊死了,换来的是延迟的确定性。你是在拿“偶尔能跑更快”换“永远不会被冻住”——对绝大多数在线服务,这笔交易划算,但它确实是一笔交易,不是白拿的。
还有两个边角。一是取整:limit 如果是 2.5 核这种小数,GOMAXPROCS 该给 2 还是 3?automaxprocs 的选择是向下取整、最低不小于 1——2.5 会变成 2,略微保守,但避免了再次烧穿配额。二是别把它当万能药:调 GOMAXPROCS 治的是“P 的数量和配额错位”这个病;如果你的服务是真的需要那么多并行、4 核配额本就不够用,那该做的是把 limit 调大,而不是把 P 数压小、然后眼睁睁看着吞吐上不去。对齐,是让运行时别再自欺;它不负责帮你把不够的资源变够。
五、一条可以带走的经验
如果这大半天只能记住一句话,我希望是这句:
一个程序对“环境”的认知,来自它启动时问操作系统的那几个问题;而它问的问题,和你以为你给它的限制,可能压根不是同一个维度。
Go 问“我能站在几个核上”,你答的却是“你每 100 毫秒能花多少 CPU 时间”——鸡同鸭讲,于是有了这场事故。而这个模式,远不止 GOMAXPROCS 一处:线程池的默认大小、GC 的触发阈值、连接池按“CPU 核数”算出来的默认并发、某些库直接拿 NumCPU() 去开 worker……凡是运行时“自动探测环境”的地方,进了容器,都值得你回头核一遍:它探到的那个数,到底是不是你以为的那个数。
线上很多“看起来没问题”的配置,问题不在配置本身写错了,而在于上下两层,对同一个词的理解,悄悄错开了。 而这种错位,监控面板上那个笑眯眯的“CPU 利用率 50%”,是不会主动告诉你的。
本文为「看起来没问题」系列复盘。事故机理均真实可复现,叙述为便于阅读做了合并与简化。