我把 Redis 的 IO 多线程打开,QPS 不升反降了 20%
一个写在 redis.conf 里、官方注释明明白白教你开的性能开关,我照着开了,QPS 没涨,反而掉了两成。这一篇是我自己交的学费。
有一次,一个吃缓存的服务压力上来了,Redis 的主线程 CPU 快打满,QPS 却顶在那儿上不去。我想起 Redis 6.0 加过一个叫 io-threads 的东西——号称单线程的 Redis 终于能吃多核了。机器是 8 核,我把 io-threads 从默认的 1 直接拉到 8,想着“火力全开”,重启,压测。
QPS 没涨。掉了大约 20%,P99 还比原来更抖。
我盯着那行配置看了很久:它就写在官方的 redis.conf 里,注释里白纸黑字教你怎么开,怎么反倒是它把性能拉下来的?
一、我当时的心智模型,错在哪
我脑子里的推理是这样的:Redis 是单线程的 → 单线程就是瓶颈 → 开多线程 = 让它并行 = 更快。这条链看着天经地义,其实每一环都在偷换概念。
第一个错:以为 io-threads 会把命令执行并行化。所以我理所当然地觉得,8 个线程 ≈ 8 倍算力。
第二个错:既然开了没变快,那一定是线程开少了吧?我把 io-threads 从 4 又加到 8,想着多多益善。结果更糟——掉得更多。
到这一步我才反应过来:如果“加线程”反而更慢,那这个开关的作用,根本不是我以为的那个。我是在拿一个错的模型,去解释一个和它相反的现象。
二、定位:CPU 更忙了,干的活却更少了
我做了三件事。
第一,换着 value 大小压。 用 redis-benchmark 分别打小 value 和大 value:
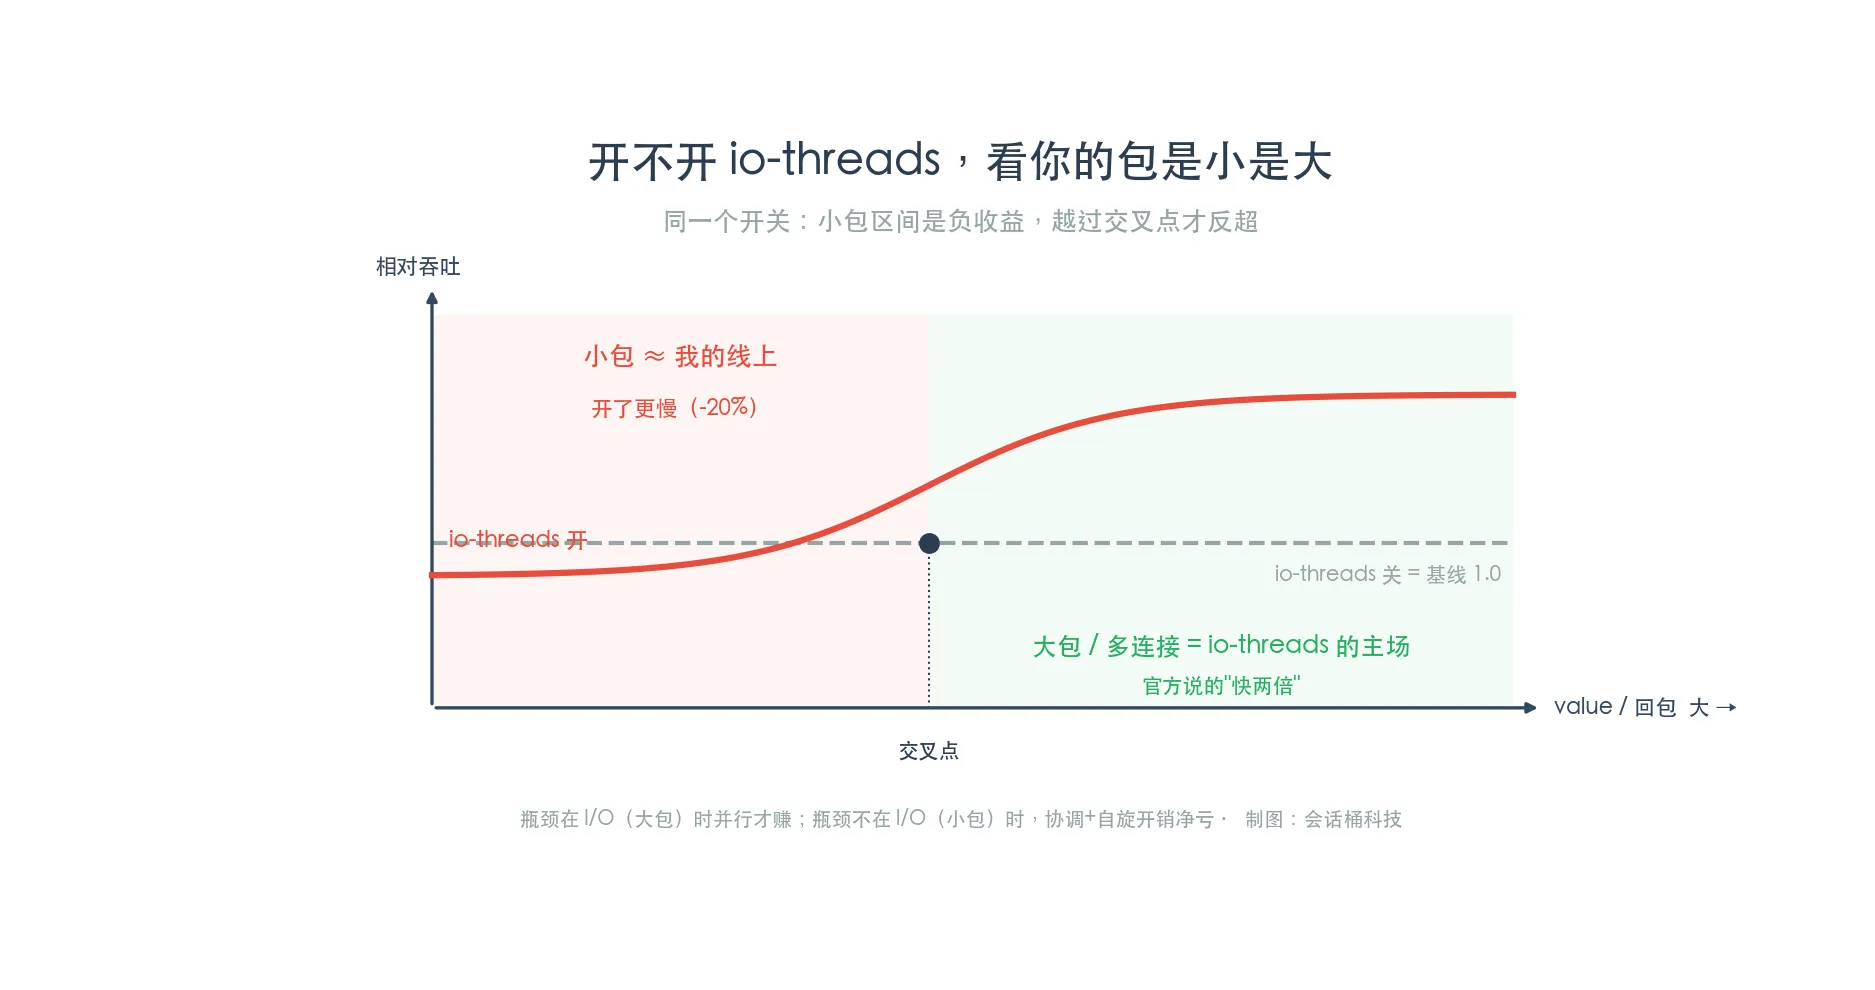
- 小 value(几十字节的 GET/SET):开 io-threads → QPS 掉。
- 大 value(几十上百 KB 的大 key、大 MGET 回包):开 io-threads → QPS 真的涨了。
同一个开关,在两种负载下方向相反。这说明它并行的不是“所有工作”,而是某一段特定的工作——而我的线上负载,恰好是它帮不上忙的那一种。
第二,top 看线程。 开了之后确实多出来几个 io 线程,个个 CPU 占用很高。但主线程执行命令那部分的速度一点没变。CPU 总使用率涨了(多核都在转),有效 QPS 却降了——CPU 花在了别处,不在“干活”上。
第三,回去把那段我没读完的注释读完。 redis.conf 里关于 io-threads 的说明,其实早把话讲明白了,只是我当初扫一眼就急着改配置:
- “When I/O threads are enabled, we only use threads for writes” —— 默认只并行“写回复”这一段,连读都不并行(要读也并行得另开
io-threads-do-reads,而官方紧接着说 “Usually threading reads doesn’t help much”)。 - “we recommend using threaded I/O only if you actually have performance problems … otherwise there is no point” —— 只有 I/O 真是瓶颈时才值得开。
- “enabling it only in machines that have at least 4 or more cores, leaving at least one spare core” —— 要留一个空核。而我 8 核开 8 线程,一个没留。
三条建议,我全踩反了。
三、根因:它并行的是“打包发货”,不是“生产”
要讲清楚,先看一条 Redis 命令的一生。从进来到返回,主线程要走五步:
- 从 socket 读出请求字节(
read系统调用) - 解析 RESP 协议,拼成一条命令
- 执行命令(真正的 GET / SET / INCR……)
- 编码回复
- 把回复写回 socket(
write系统调用)
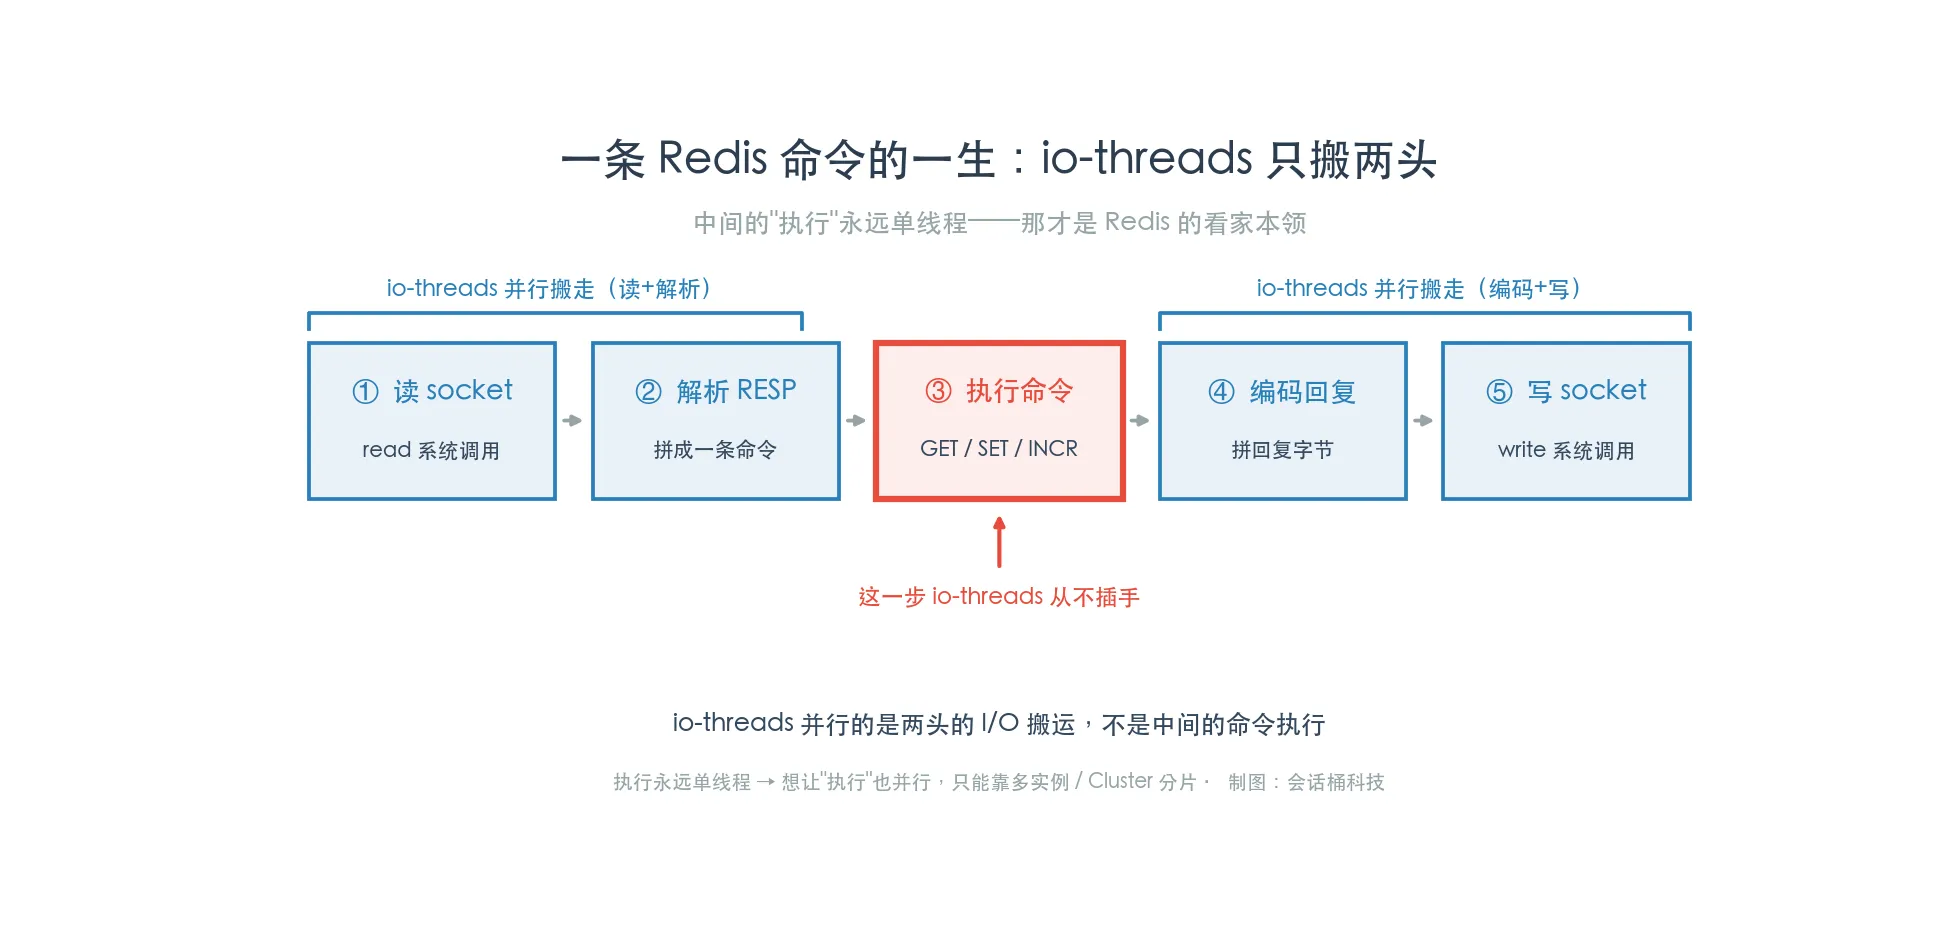
Redis 的看家本领,是第 3 步执行永远单线程——正因为单线程,它才没有锁、没有竞态,简单又快。io-threads 从头到尾没碰这一步,将来也不会碰。它动的只是两头的第 1、2、4、5 步:把“读+解析”和“编码+写回”这些纯 I/O 搬运,分给一个线程池并行做。
打个比方:执行命令是“生产”,I/O 是“把货装箱、发快递”。io-threads 请了几个工人帮你打包发货,但生产线还是只有一条。
那它具体怎么干活?用的是 fan-out / fan-in 模型:主线程把这一轮就绪的连接,轮流分给几个 io 线程和它自己(fan-out);大家各读各写;然后主线程自旋等待(busy-wait,空转着等、不睡)所有 io 线程做完(fan-in),才继续往下串行执行命令。
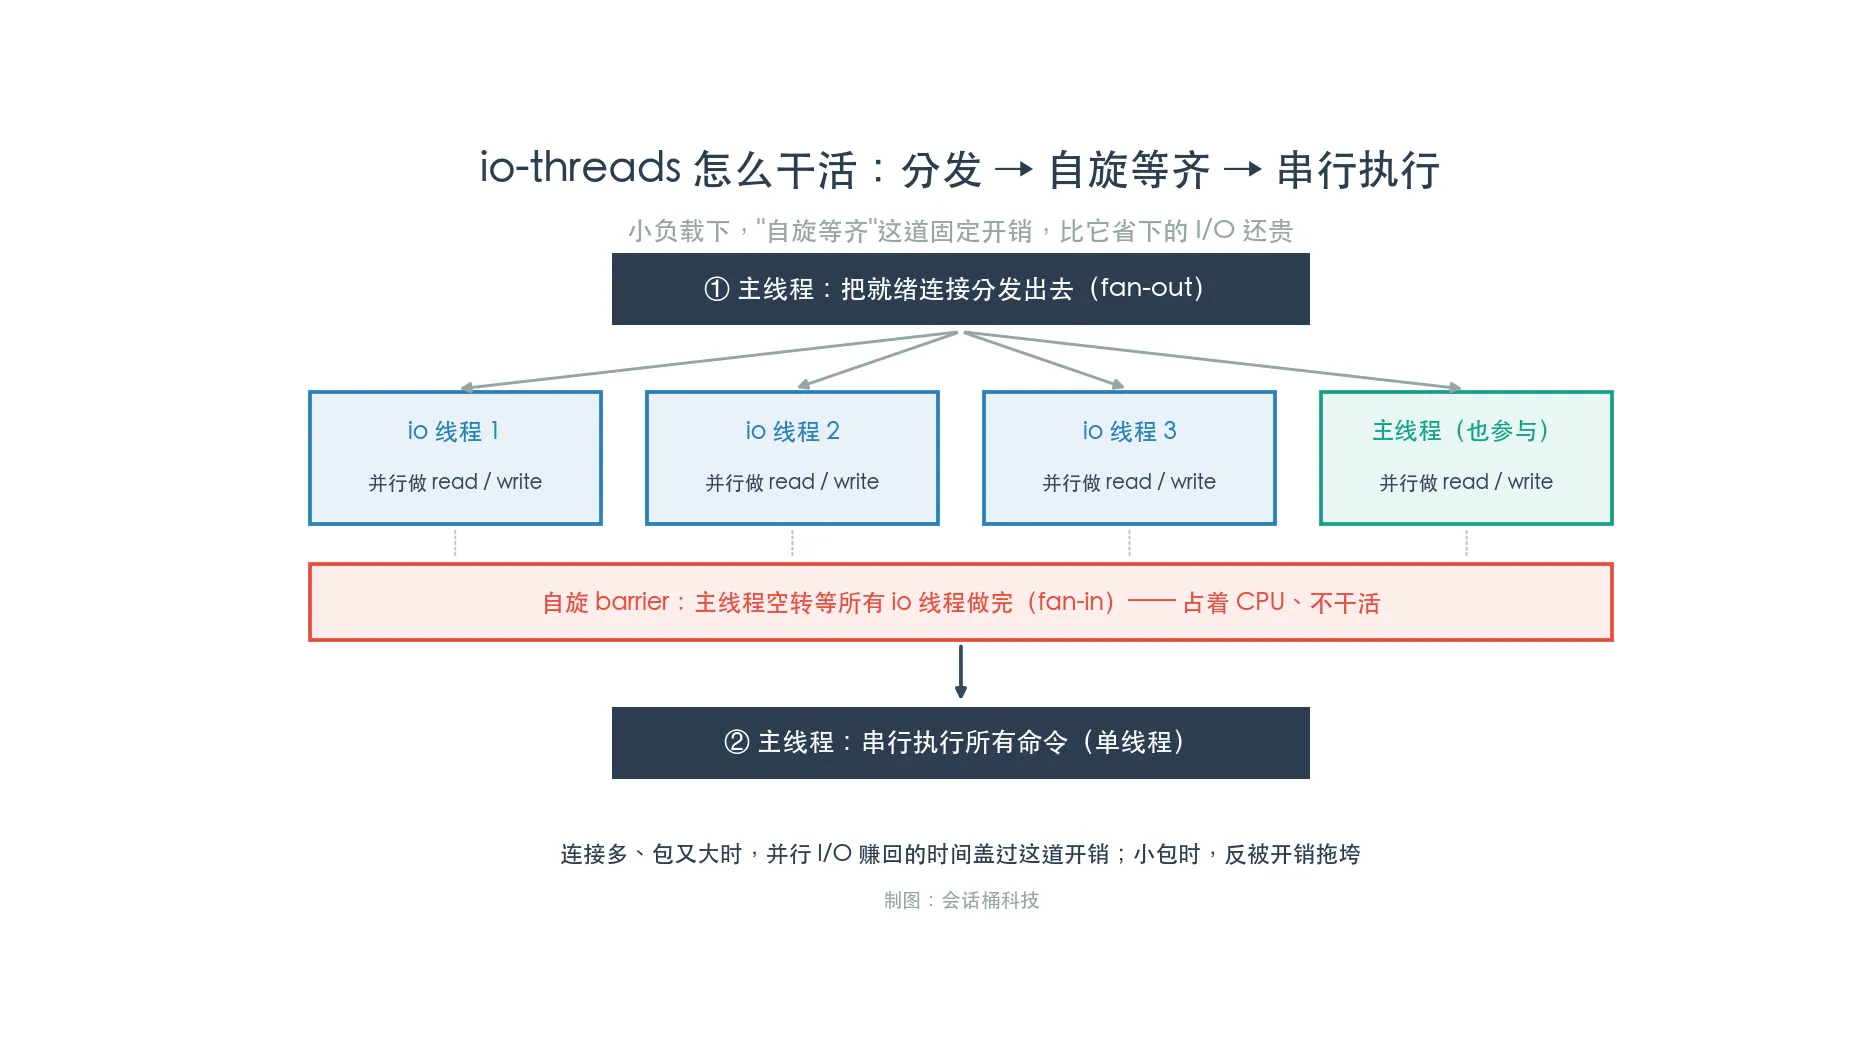
成本结构就藏在这个模型里:
只有当“打包发货”确实是瓶颈时,多请工人才划算。 什么时候是?value 很大、回包很大、连接很多——这时 write 那个系统调用、那些缓冲区拷贝真的很重,并行起来立竿见影。官方那句“不用 pipelining、不用分片就能快两倍”,说的正是这种场景。
而我的负载是小 value。 每个请求的 I/O 小得可怜,读写各自几微秒。这时候这笔账是:
- 并行省下来的 I/O 时间 → 微乎其微;
- fan-out 分发 + 自旋 barrier 每一轮事件循环都要固定付的协调开销 → 实打实加在了关键路径上;
- 更要命的是,我 8 核开 8 个自旋线程,一个空核没留。那些空转等活的 io 线程,在和主线程抢 CPU、抢 cache、抢内存带宽——而真正决定 QPS 的那条单线程执行流,反被它们拖慢了。
省的那点微乎其微,付的却是固定协调 + 自旋抢核。一加一减,QPS 掉 20%。执行仍然单线程、一点没变快,我却白白给它加了一路过路费。
四、怎么改的,以及代价
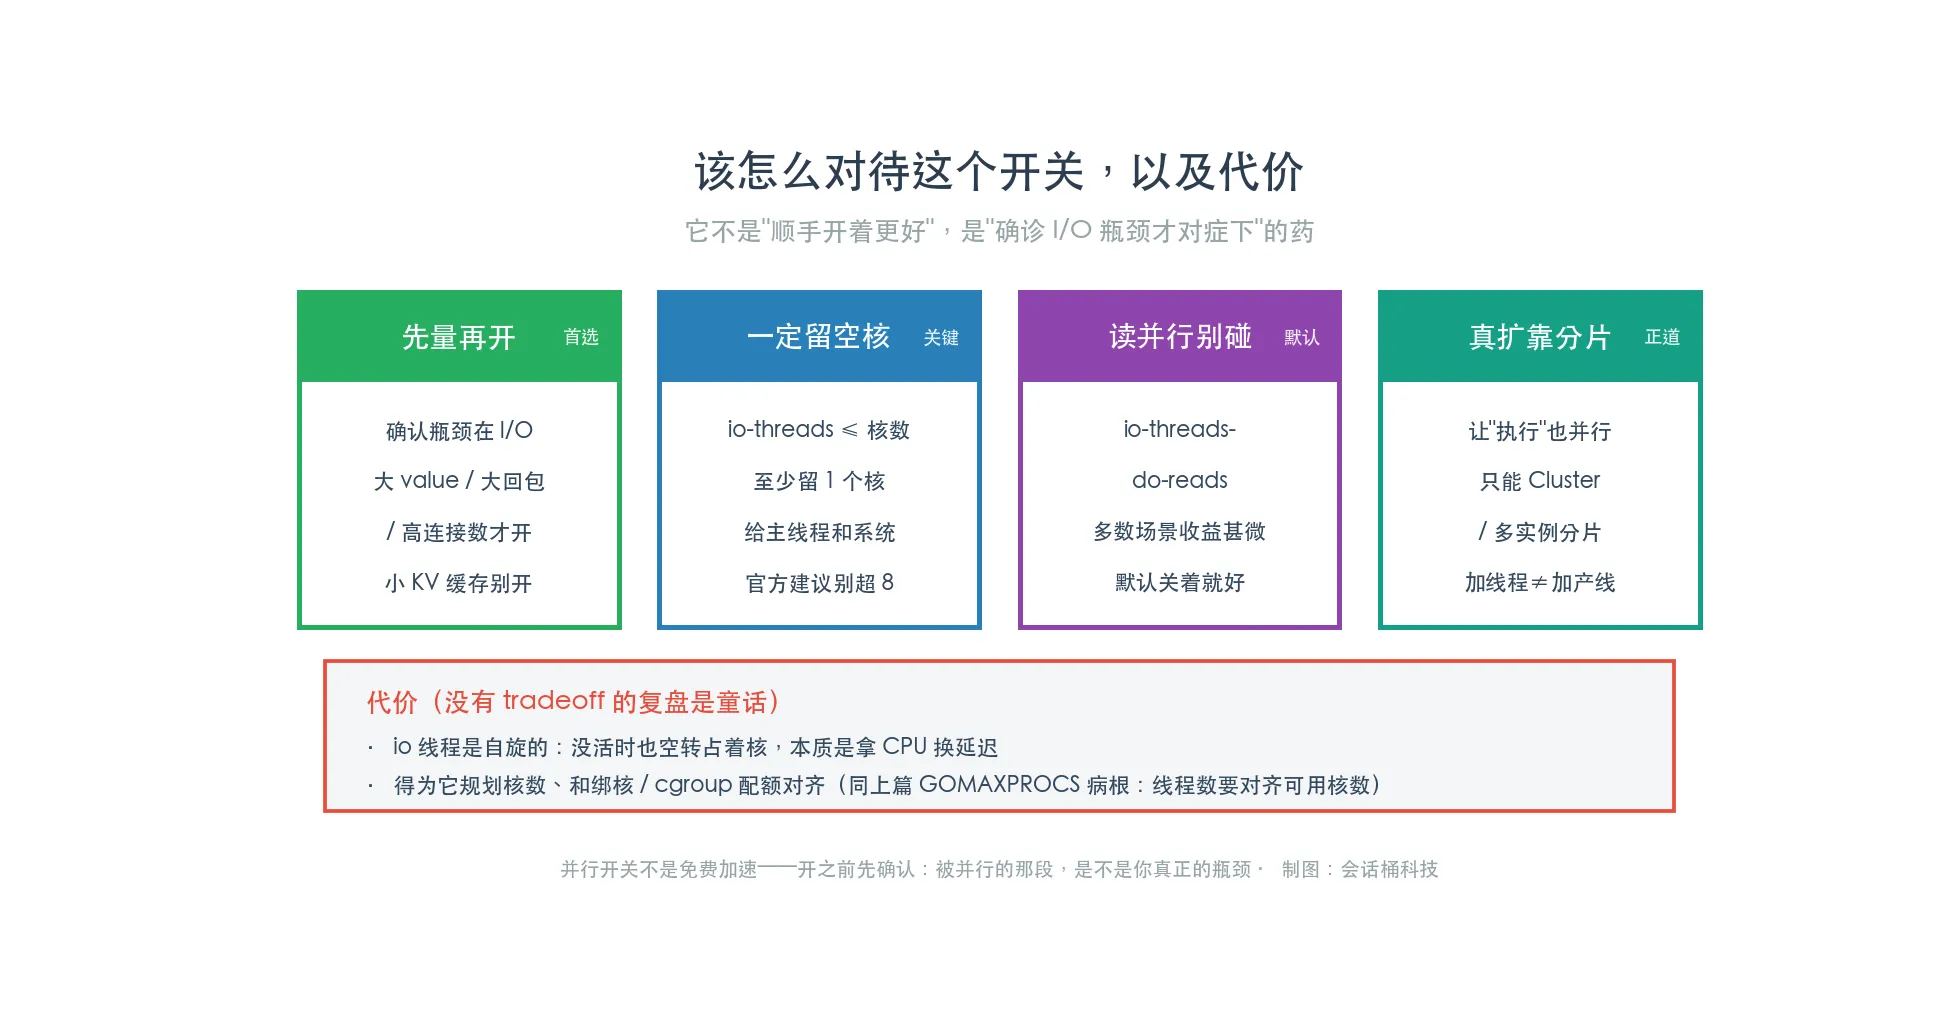
想通之后,改法其实就是把官方那三条读进去:
- 先量再开。 只有确认瓶颈在 I/O(大 value / 大回包 / 高连接数,且主线程 CPU 高在 I/O 上)才开 io-threads;小 value 的 KV 缓存别开,老老实实单线程反而最快。
- 开也要留空核。
io-threads不超过物理核数,还得留至少一个核给主线程和系统;官方建议别超过 8。8 核我最后设了 3,而不是 8。 - 读并行基本别碰。
io-threads-do-reads多数场景收益甚微,默认关着就好。 - 真要水平扩,靠分片不靠加线程。 想让“执行”也并行,正道是 Redis Cluster / 多实例分片——一条生产线不够,就再开一条产线,而不是给同一条线多派打包工。
代价也得说清楚,没有 tradeoff 的复盘是童话:
io-threads 的那些线程是自旋的——没活的时候也在空转占着核,本质是拿 CPU 换延迟。开它就得为它规划核数、和绑核 / cgroup 配额对齐。这一点和上一篇 GOMAXPROCS 是同一个病根:线程数要和你真正能用的核数对齐,多开的线程不是白送的算力,是抢资源的负担。 部署也更复杂。所以它不是一个“顺手开着更好”的开关,而是一味“确诊了 I/O 瓶颈才对症下”的药。
五、一条可以带走的经验
如果这场事故只留一句,我想留这句:
多线程从来不是免费加速。它只在“被并行的那一段,恰好就是你的瓶颈”时才赚;否则,分发和同步的固定开销,会反过来吃掉你的吞吐。
io-threads 并行的是 I/O,不是执行;而我的瓶颈根本不在 I/O。开关本身没错,错在我没搞清楚它并行的那段,是不是我真正卡住的那段。
所以下次再看到任何一个“打开就更快”的并行开关——GOMAXPROCS、连接池大小、消费者并发数、io-threads——先别急着拨。先问自己一句最朴素的话:我真正的瓶颈在哪一段?这个开关,并行的是不是正好那一段? 想清楚这一句,你就绕开了“多线程 = 更快”这个几乎人人都栽过的直觉陷阱。
本文为「看起来没问题」系列复盘。事故机理均真实可复现,叙述为便于阅读做了合并与简化。