服务内存涨到 OOM,可我真的没有内存泄漏
内存曲线一路只涨不跌,最后被 OOM Killer 干掉。可我翻遍 pprof 的 heap profile,找不到任何一处「忘了释放」——每个对象看起来都该在。没有泄漏,它就是在漏。
有一次,一个 Go 写的接口服务,上线跑得好好的,过几个钟头内存就爬到上限,被 OOM Killer 杀掉,然后重启、再爬、再被杀——像有个漏水的桶。
我的第一反应很自然:内存只涨不跌,那不就是内存泄漏吗?找那个“忘了释放”的地方就是了。
可 Go 是有 GC 的语言。我盯着 pprof 的 heap profile 看了很久,越看越困惑:占内存的大头是一堆再正常不过的对象——请求结构体、几个 buffer——每一类都“该在那儿”,没有哪个大对象能让我指着说“就是你,泄了”。
一个有 GC 的语言、一份查不出泄漏点的 profile、一条只涨不跌的内存曲线。这三件事凑在一起,怎么看怎么矛盾。
一、我当时的心智模型,错在哪
我脑子里的推理是:内存涨 → 有东西没被释放 → 找到它、释放它。这套逻辑在 C 里是对的,但我把它原封不动搬到了 Go,第一步就错了。
第一个错:认定“内存只涨 = 内存泄漏 = 有对象忘了释放”。于是我一头扎进 heap profile,去找那个只增不减的大 map、那个用错的 sync.Pool、那个越堆越大的 cache。方向从一开始就偏了。
第二个错:heap profile 查不出,我就怀疑是不是 GC 没干活——是不是 GOGC 调得太保守、是不是有什么东西一直被引用着不放。我甚至去翻 GC 的日志。结果 GC 跑得勤快又健康,每轮都正常回收。又一个错误方向。
到这一步我才意识到问题:我一直在“内存”这个维度里找答案,但真正涨的东西,也许根本不是我盯着的那个维度。GC 没偷懒,heap 里也没有孤儿对象——那涨的是什么?
二、定位:涨的不是内存,是 goroutine
我做了两件事,真相就出来了。
第一,加一个最朴素的监控指标:runtime.NumGoroutine()。 我一直盯着内存,却从没看过 goroutine 数。补上之后,曲线一目了然:goroutine 数量只涨不跌,而且和内存曲线几乎完全同步——每来一波流量,涨一截,永远不回落。
第二,拉 pprof 的 goroutine profile(注意,是 goroutine,不是 heap)。 一看,好几千个 goroutine,绝大多数卡在同一行代码上,状态全是 chan send——它们都堵在往一个 channel 里发数据,谁也发不出去。
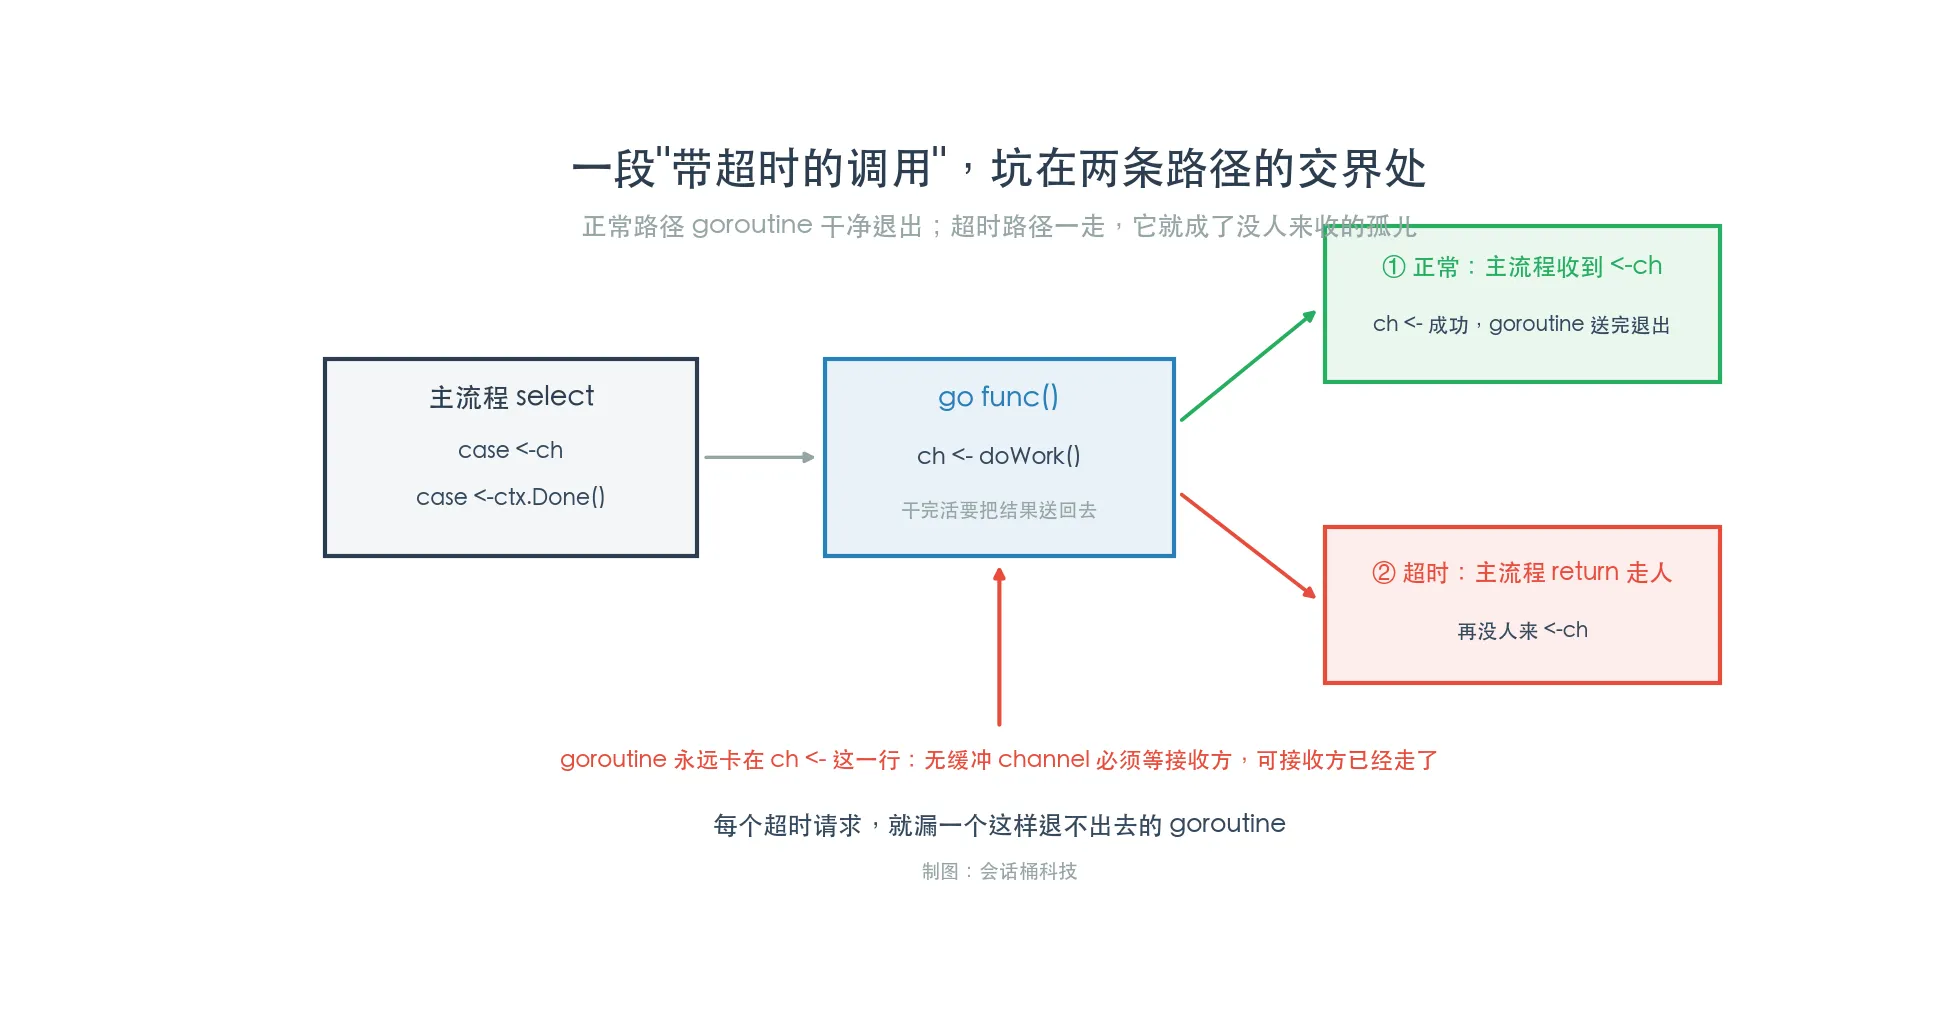
那行代码,是我一段“带超时的调用”里的。伪代码长这样,你八成也写过、也在 review 里放过类似的:
func fetch(ctx context.Context) (Result, error) {
    ch := make(chan Result)          // 无缓冲 channel
    go func() {
        ch <- doWork()               // 干完活,把结果送回去
    }()
    select {
    case r := <-ch:
        return r, nil                // 正常:收到结果
    case <-ctx.Done():
        return Result{}, ctx.Err()   // 超时:直接走人
    }
}
每一行单独看都对。启一个 goroutine 去干活、主流程 select 等结果或等超时——这是 Go 里最标准的超时写法,摆在 review 里我自己都会放行。
坑在两条路径的交界处:一旦走了 ctx.Done() 这条超时分支,fetch 就 return 了,再也没有人会去 <-ch。而那个 goroutine 还堵在 ch <- doWork() 上,等一个永远不会来的接收者。channel 无缓冲,发送方必须等接收方就位才能完成——可接收方已经走了。于是这个 goroutine,永远卡在这一行,退不出去。
每一个超时的请求,就漏一个这样的 goroutine。
三、根因:没有泄漏,只有“滞留”
现在能解释那个最矛盾的点了:为什么 heap profile 查不出泄漏。
因为根本没有泄漏。
一个卡在 chan send 上的 goroutine,它没有死、也没有被回收——它只是被永久挂起(park)了。而它还活着,就意味着:它的整个栈、它闭包里捕获的所有变量(那个 ctx、那个即将发送的 Result、doWork 过程中引用的一切),在 GC 眼里全都是可达的。
GC 的工作是回收“不可达”的垃圾。可这些对象每一个都被一个活着的 goroutine 明明白白地引用着——它们不是垃圾,是被合法占用的活对象。GC 一点没偷懒,它精确地判断出“这些还有人用”,然后老老实实地留下了它们。
所以这不是泄漏(leak),是滞留(一堆卡死的 goroutine,合法地占着内存不放)。heap profile 当然查不出来——profile 只会告诉你“这些对象还活着、还被引用着”,它没法告诉你“引用它们的那个 goroutine 其实已经卡死、再也不会用到它们了”。
内存只是表象。真正只涨不跌的是 goroutine 数量,内存不过是被这群僵尸 goroutine 拖着一起涨的赃物。
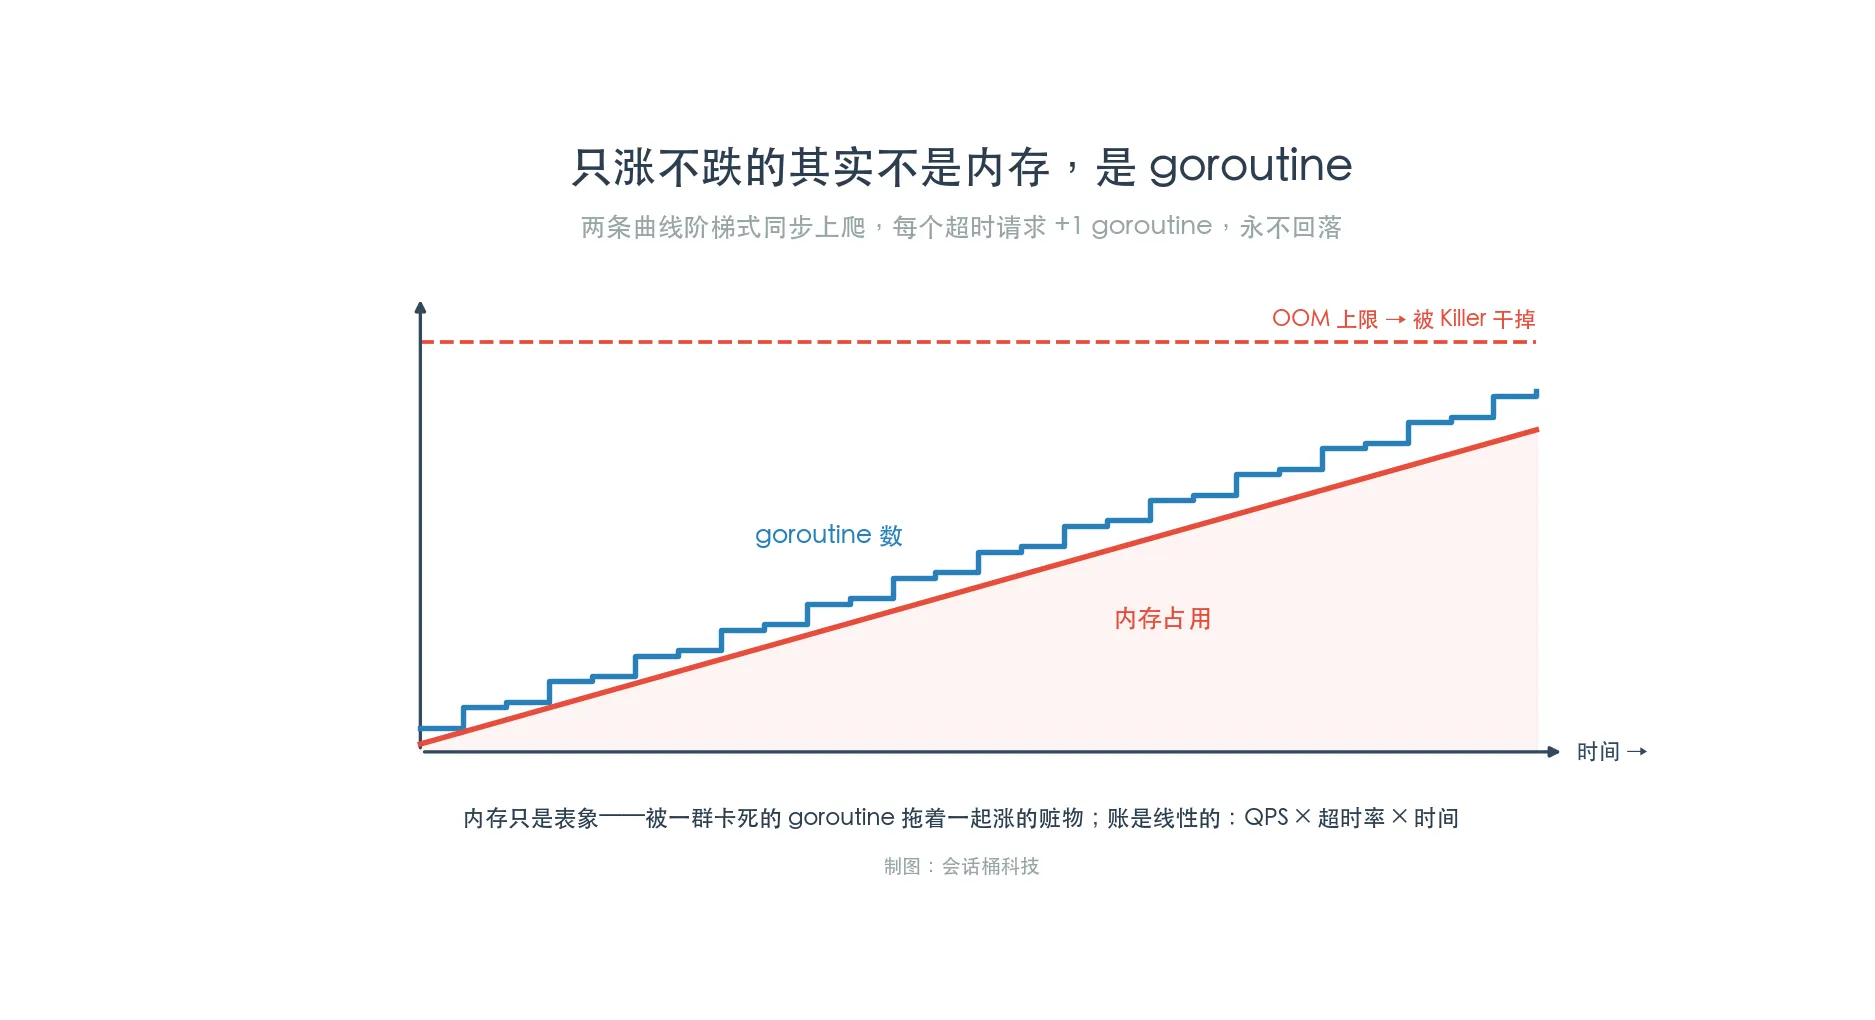
账算起来是线性的:QPS × 超时率 × 运行时间。平时超时率低,漏得慢,你甚至发现不了;一旦某个下游变慢、超时率飙上去,goroutine 就成片成片地漏,内存加速冲顶,OOM 就在眼前。
四、怎么改的,以及代价
直接的病因是“发送方发不出去”,所以最小的止血改动只有一个字符——把 channel 加个缓冲:
ch := make(chan Result, 1) // 容量 1有了这个容量 1 的缓冲,goroutine 的 ch <- doWork() 永远能立刻完成:哪怕主流程已经超时走人、没人来收,结果也能先塞进缓冲区,goroutine 送完就正常退出,不再卡住。孤儿没了。
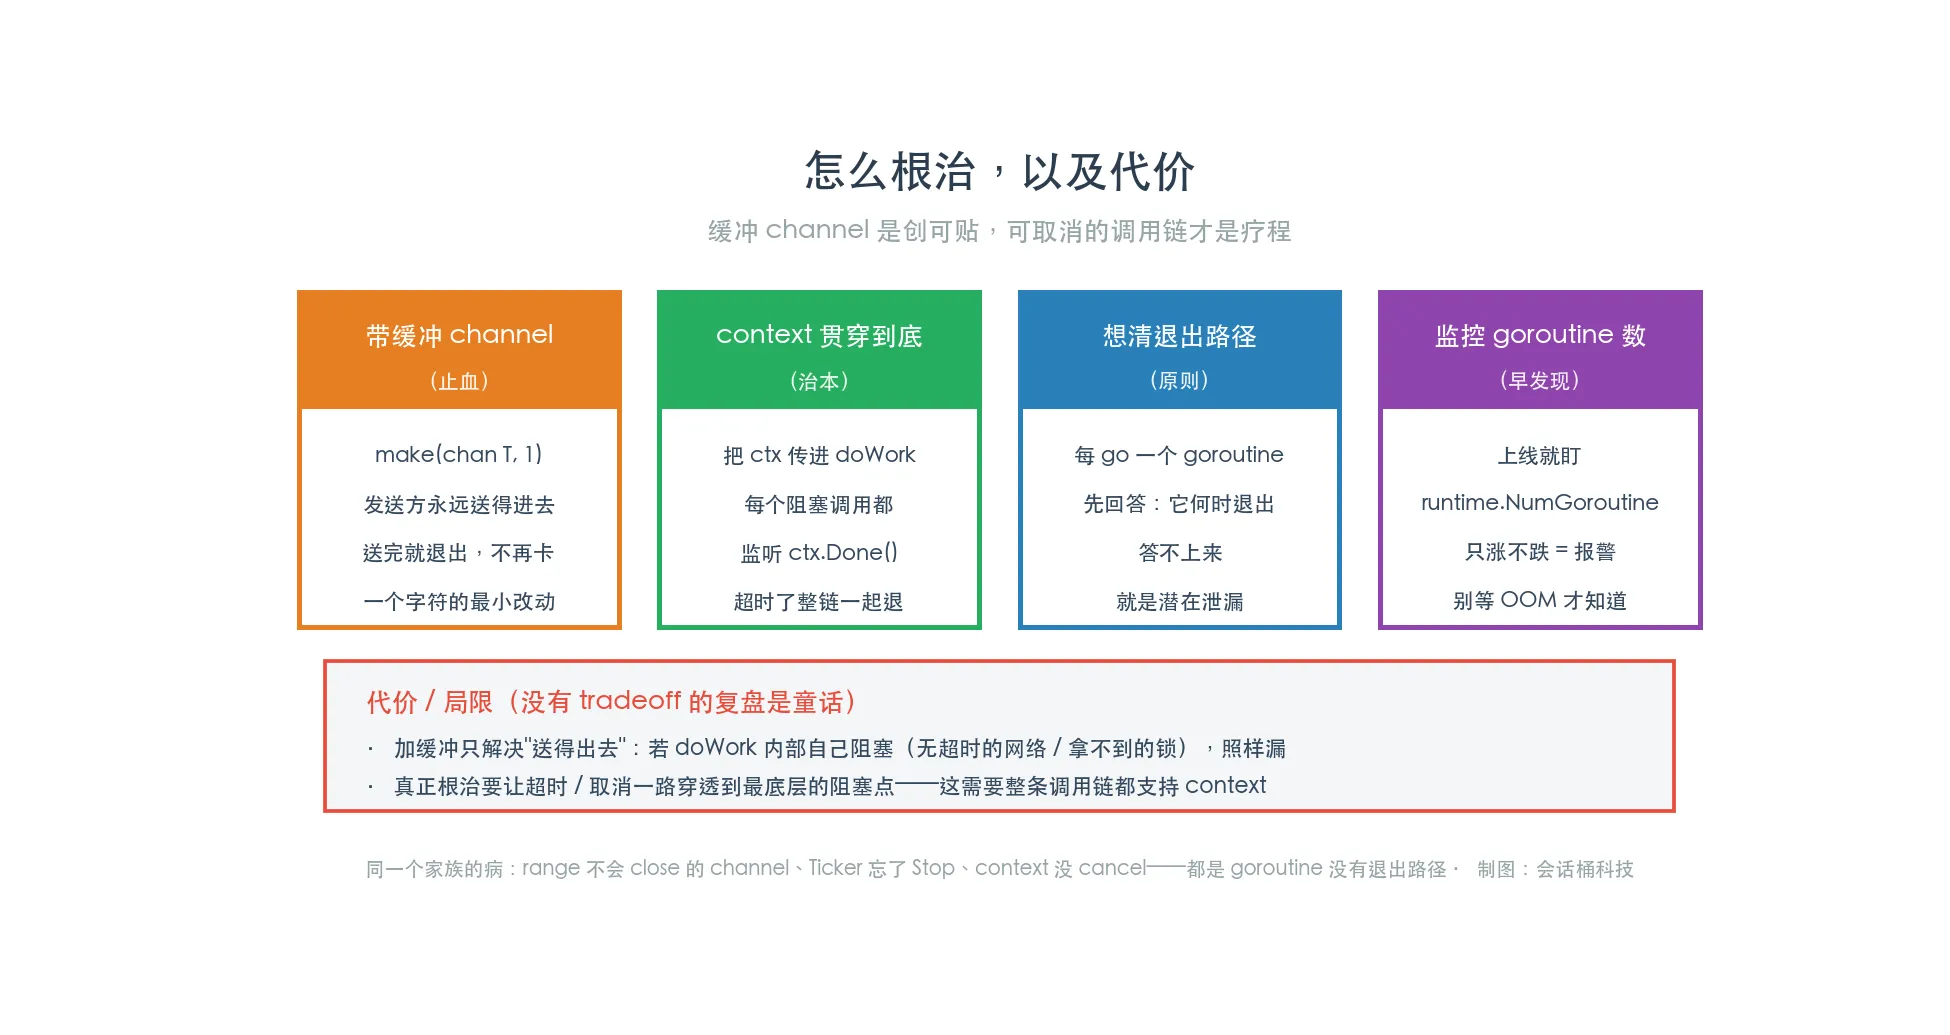
但只做这一步,是止血不是根治。代价和局限得说清楚,没有 tradeoff 的复盘是童话:
缓冲只解决了“送得出去”,没解决“goroutine 会不会自己卡死在别处”。 如果 doWork() 内部本身就阻塞——比如卡在一个没设超时的网络请求、一把拿不到的锁上——那它连 ch <- 都走不到,缓冲再大也没用,goroutine 照样漏。所以真正的根治,是让超时/取消能一路穿透到最底层的阻塞点:把 ctx 传进 doWork,让里面每一个可能阻塞的调用都监听 ctx.Done(),超时一到,整条调用链都能主动退出。缓冲 channel 是创可贴,可取消的调用链才是疗程。
这也是一整个家族的病,根子都一样——goroutine 没有明确的退出路径:
for range一个永远不会被 close 的 channel;- 起了
time.Ticker忘了Stop(),背后的 goroutine 一直在跑; - context 没 cancel,派生出去的 goroutine 不知道该收工。
它们表现出来都是“内存只涨不跌像泄漏”,本质都是 goroutine 退不出去。
五、一条可以带走的经验
如果这场事故只留一句,我想留这句:
Go 里的“内存泄漏”,绝大多数泄的不是内存,是 goroutine。 内存只是被一群卡死的 goroutine 合法占着、跟着一起涨的赃物。GC 会替你回收不可达的垃圾,但它救不了一个“还活着、只是永远卡住”的 goroutine——在它眼里,那不是垃圾。
所以下次再遇到内存只涨不跌,别急着一头扎进 heap profile 找大对象。先加一行监控、看一眼 runtime.NumGoroutine() 那条线在不在同步爬——如果在,问题九成不在内存,在并发。
再往深一层说,这事给我立了一条规矩:每 go 出去一个 goroutine,都要能当场回答一个问题——它在什么情况下会退出? 答得上来,它就是安全的;答不上来、或者要愣一下,那它就是一个还没发作的泄漏。启动一个 goroutine 从来都很便宜,而想清楚它怎么结束,才是你真正要付的那笔钱。
本文为「看起来没问题」系列复盘。事故机理均真实可复现,叙述为便于阅读做了合并与简化。