我的网关一个字段都没改,订单号却变了
没有报错、没有 panic、没有超时,
Unmarshal返回 nil,Marshal也返回 nil,日志从头到尾干干净净。数据就这么安安静静地错了——一个只做转发的网关,代码里一行都没碰过order_id,订单号却在它手里变成了另一个数。
有一次,线上开始零星地报“订单查不到”。
不多,但不是偶发——每天都有那么一批,客服那边能收到工单,对账的时候也能对出差额。查下来的现象很具体:用户下单成功了,订单确实进了库,但拿着这个订单号去下游系统查,查不到。
把两边的号拉出来一比,我愣了一下:
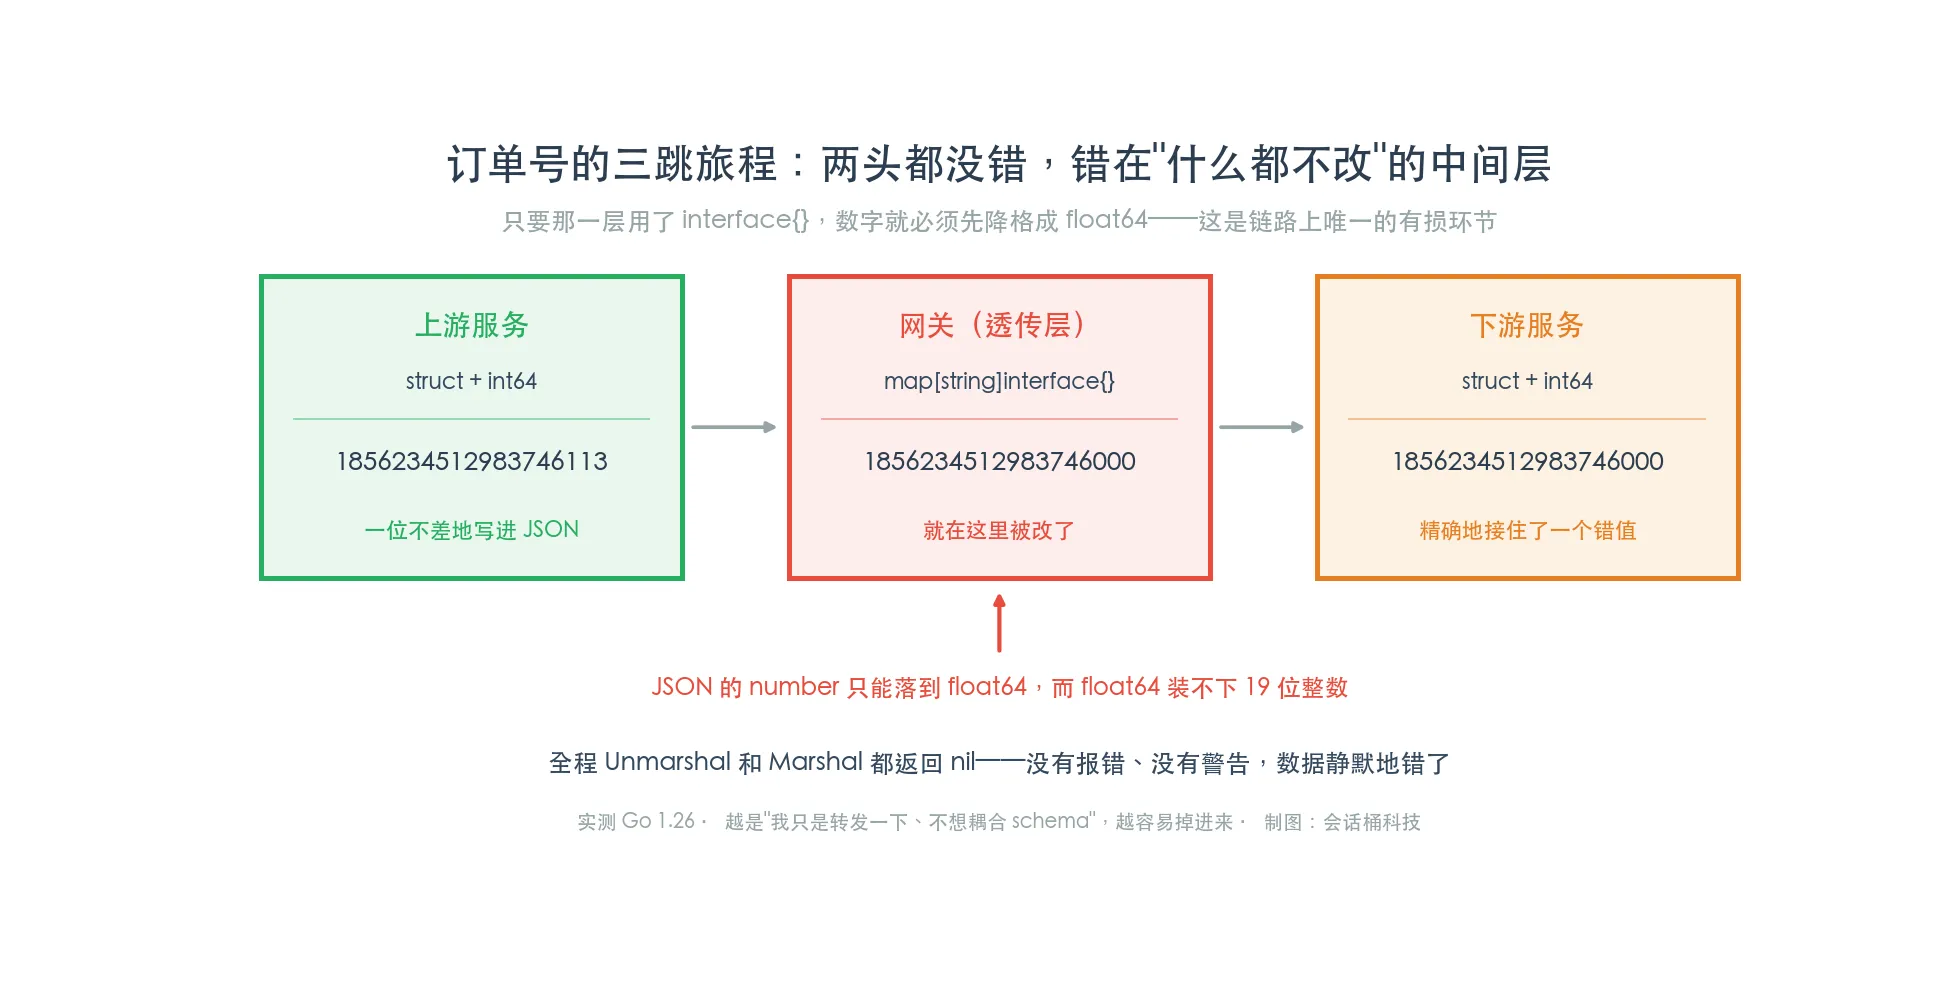
上游发出:1856234512983746113
下游存的:1856234512983746000
前 16 位一模一样,末尾三位变成了 000。
链路中间只有一个网关。而那个网关的职责,就是把上游的 JSON 收下来、加一个 trace 字段、原样转发给下游。它的代码里,根本没有一行提到过 order_id。
一个没碰过这个字段的服务,把这个字段改了。
一、我当时的错误判断
现在回头看,这段是我绕得最远、也最值钱的部分。
第一个错:先怀疑人,不怀疑机器。 末尾三位变 000,第一反应是上游哪个地方把 ID 截断了、或者拼字符串的时候格式化错了。于是我去抓上游发出去的包——原始报文里躺着的就是完整的 1856234512983746113,一位不差。上游是清白的。
第二个错:怀疑存储。 那大概是下游落库的时候被数据库改了?字段是不是设成了 decimal 或者位数不够的类型?翻了表结构,bigint,int64 装 19 位数字绰绰有余。而且我在下游服务收到请求的入口打了日志——它收到的时候就已经是 000 了。存储也是清白的。
第三个错,也是耽误我最久的:以为这是“数据错乱”。 我脑子里一直挂着“串号”这个词——是不是并发下把别人的订单号写串了?是不是缓存 key 冲突了?我照着这个方向查了一圈连接复用和上下文传递,一无所获。
真正让我掉头的,是我把几十条出错的记录并排放在一起看的那一刻。它们不是随机乱的:
1856234512983746113  →  1856234512983746000
7304829165018273401  →  7304829165018274000
1234567890123456789  →  1234567890123456800
每一条,前面十几位都对,只有末尾几位被抹平了。 而且第二条更蹊跷——末尾是 3401,抹完变成了 4000,它不是被截断,是进位了。
到这一步,“串号”这个假设彻底站不住了。串号是换成另一个不相干的数,而这个是同一个数被“挪”了一点点。这个味道我认得——这不是数据错乱,这是精度损失。
可是……一个只做 JSON 转发的网关,哪来的浮点数?
二、定位:它压根就不是个整数
带着这个疑问,我在网关里加了一行最笨的日志,把收到的这个字段连类型一起打出来:
log.Printf("order_id = %v, type = %T", m["order_id"], m["order_id"])order_id = 1.8562345129837461e+18, type = float64float64。
那一刻所有事情都对上了。而那行“罪魁祸首”的代码,是网关里最普通、最不可能被 review 拦下来的一行:
var m map[string]interface{}
if err := json.Unmarshal(body, &m); err != nil {
    return err
}
m["trace_id"] = traceID          // 我只动了这一个字段
out, _ := json.Marshal(m)        // 然后原样转发
一个透传层,用 map[string]interface{} 把 body 接一手,塞个 trace 进去,再编码发走。这是网关最标准的写法——正因为它不想跟上游的 schema 耦合,才刻意不定义结构体。这段代码摆在 review 里,我自己也会毫不犹豫地放行。
但就是这两行,把订单号改了。
我把它单独拎出来跑了一遍,err 全程是 nil:
原始 JSON : {"order_id":1856234512983746113}
解出来的类型: float64
再 Marshal : {"order_id":1856234512983746000}
没有报错。没有警告。没有任何一个返回值告诉你出事了。 Unmarshal 认为自己成功了,Marshal 也认为自己成功了。它们说的都是实话——从它们的职责看,这次转换确实是“成功”的。
三、根因:JSON 里根本没有“整数”这种东西
这件事的根,比 Go 深一层。
JSON 规范(RFC 8259)里,数字类型只有一个,叫 number,是一个十进制数。它没有整数和浮点数之分。 规范自己在文档里就打了预防针:由于大量实现是拿 IEEE 754 双精度来承载 number 的,只有落在 ±(2⁵³−1) 范围内的整数才保证跨实现互通。
所以当 Go 拿到 1856234512983746113 这串字符、而你给它的容器是 interface{}(它对目标类型一无所知)时,它必须挑一个具体类型来装。JSON 的 number 只对应一个类型:float64。它没得选,也没有理由报错——它完全按规范办事了。
问题出在 float64 装不下这个数。
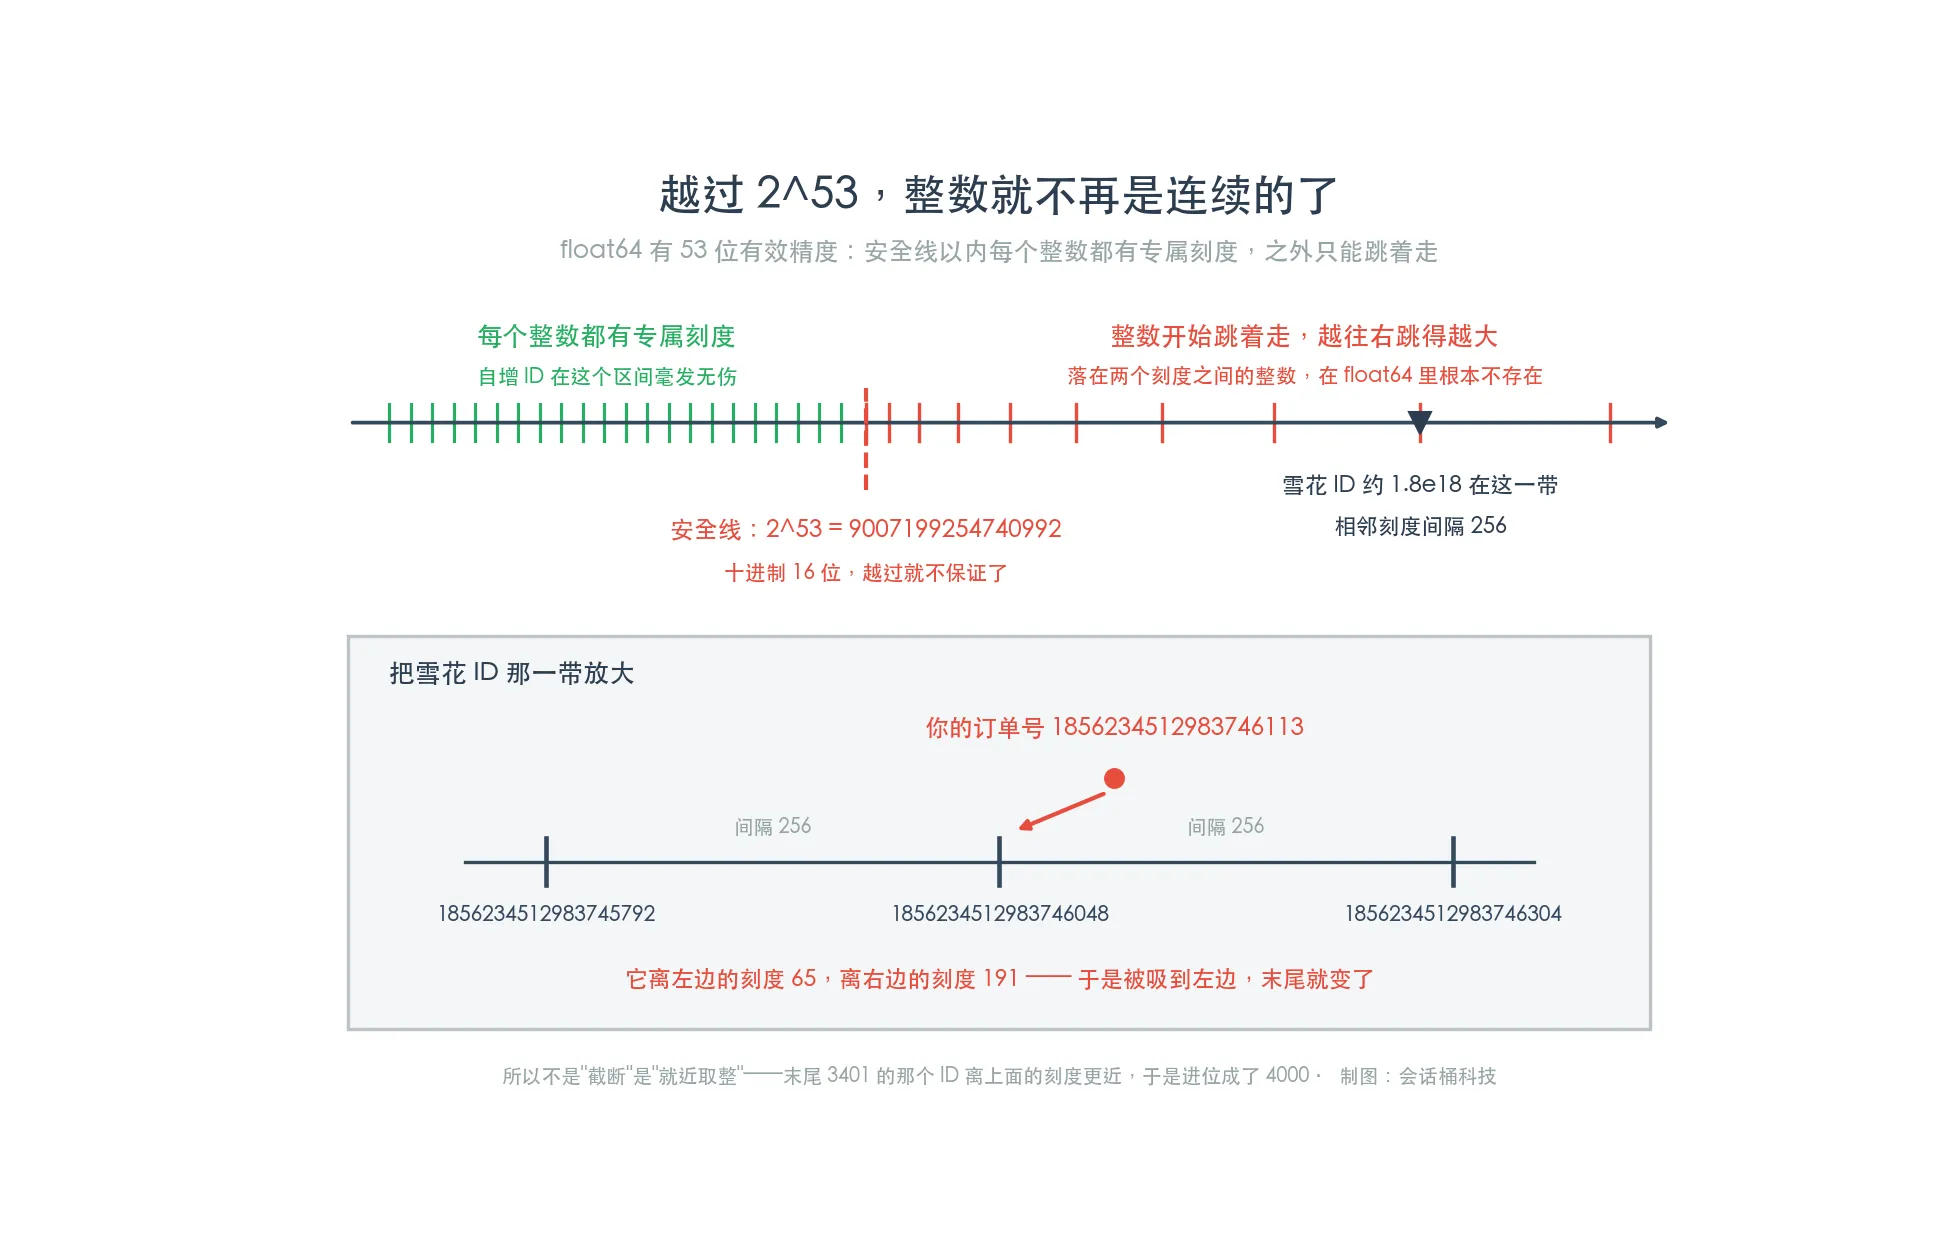
float64 一共 64 位:1 位符号、11 位指数、52 位尾数。加上一个隐含的最高位,它能精确表示的整数上限是 2⁵³ = 9007199254740992,也就是 9 千万亿,十进制 16 位。
超过这条线之后,会发生一件很多人没意识到的事:整数变稀疏了。
在 2⁵³ 以内,每一个整数都有一个专属的 float64,严丝合缝。越过 2⁵³,可表示的整数开始跳着走——先是每 2 个能表示一个,然后每 4 个、每 8 个……在雪花 ID 那个量级(约 1.8×10¹⁸,落在 2⁶⁰ 到 2⁶¹ 之间),相邻两个能被精确表示的整数之间,隔着 256。
你的订单号如果不是 256 的倍数,它在 float64 的世界里就不存在。浮点数只能把它吸附到最近的那个刻度上。所以不是截断,是就近取整——这就是为什么 ...273401 会变成 ...274000:离它最近的那个刻度在上面。
这里还有一个更绕的细节,是我后来才注意到的。以 1234567890123456789 为例:
原始字符串        : 1234567890123456789
内存里的 float64  : 1234567890123456768   ← 就近吸附的结果
重新编码成 JSON   : 1234567890123456800   ← 又不一样了!
你 debug 时打印出来的值,和实际发出去的值,还不是同一个数。 因为编码器输出浮点数时用的是“能唯一还原这个 float64 的最短十进制表示”——...800 和 ...768 在 float64 里是同一个刻度,那就挑短的写。于是这个数在一趟旅程里被改了两次,两次都“没有错”。
为什么它能骗过 code review
这才是这个坑真正阴的地方——链路上每一个服务单独看都是对的:
- 上游:用结构体 +
int64序列化,19 位数字原样写进 JSON,无损; - 下游:用结构体 +
int64反序列化,int64装得下 19 位,也无损; - 只有中间那个“什么都不做”的透传层,因为用了
interface{},成了整条链路上唯一一个把数字降格成浮点数的地方。
我验证过,只要不走 interface{},一切正常:
type Order struct {
    OrderID int64 `json:"order_id"`
}
// 解出来:1856234512983746113,重新编码:1856234512983746113 —— 一位不差也就是说,越是“我什么都不改,我只是转发一下”,越容易中招。 因为正是“不想耦合 schema”这个正确的动机,把你推向了 map[string]interface{}。
而且这个坑跟嵌套深度无关,只要那一层是 interface{},藏得再深也一样:
进:{"data":{"items":[{"id":1856234512983746113}]}}
出:{"data":{"items":[{"id":1856234512983746000}]}}
这也不是 Go 的问题
我特意拿 JavaScript 对照跑了一遍同一个订单号:
Number.MAX_SAFE_INTEGER          // 9007199254740991  ← 正是 2⁵³−1
JSON.parse('{"id":1856234512983746113}').id
// 1856234512983746000            ← 一模一样的错值
同一个数,同一个坑,同一个错误结果。 前端拿到的、Python 拿到的、PHP 拿到的,都是这个数。这不是 Go 的 bug,是 JSON 这个格式与生俱来的性质:它的数字是十进制文本,而绝大多数实现拿双精度浮点来承载它。
顺带一提,如果数字再大到 10²¹ 以上,Go 的编码器还会直接把它写成科学计数法 1e+21——那时候下游多半就不是“值错了”,而是解析直接崩了。从这个角度说,崩掉反倒是好事:能立刻发现的错,比静默改数据的错便宜得多。
四、怎么改,以及代价
这个坑有四种改法,但它们不是并列的,代价差得很远。
① 最小止血:Decoder.UseNumber()。 让解码器把数字解成 json.Number——本质是保留原始字符串,用的时候再自己决定转 int64 还是 float64:
dec := json.NewDecoder(bytes.NewReader(body))
dec.UseNumber()
dec.Decode(&m)
// m["order_id"] 的类型是 json.Number,重新编码:1856234512983746113 ✅代价:json.Unmarshal 没有这个开关,必须换成 Decoder;而且下游所有做类型断言的地方都得跟着改(原来 .(float64) 的地方现在是 .(json.Number))。它只治你自己这一跳。
② 透传层的最优解:json.RawMessage——干脆别解开。 网关既然只关心几个字段,就只定义那几个,其余的用 RawMessage 让原始字节原封不动地穿过去:
type Envelope struct {
    TraceID string          `json:"trace_id"`
    Data    json.RawMessage `json:"data"`   // 原始字节,不解析
}
没解析过的字节,就没有被翻译过,自然也没有精度损失。而且顺带省了一大笔序列化的 CPU。代价:只适用于“你确实不需要看里面”的场景,一旦要按内容路由,就得解。
③ 真正的根治:ID 用字符串传。 在协议层就把 ID 定义成 string,或者给结构体字段挂上 json:"order_id,string"。字符串在任何语言里都没有精度这回事:
{"order_id":"1856234512983746113"} → {"order_id":"1856234512983746113"}代价:这是改协议,上下游要一起动,历史数据要兼容,推动成本最高——但它是唯一一个能保证“链路上再冒出第几个中间件都不会出事”的方案。
④ 定义完整结构体用 int64 接。 最直白,但对透传层来说是反的:网关本来就是为了不跟上游 schema 耦合才用 map 的,改成完整结构体等于把耦合又请回来,上游加个字段你就得跟着发版。
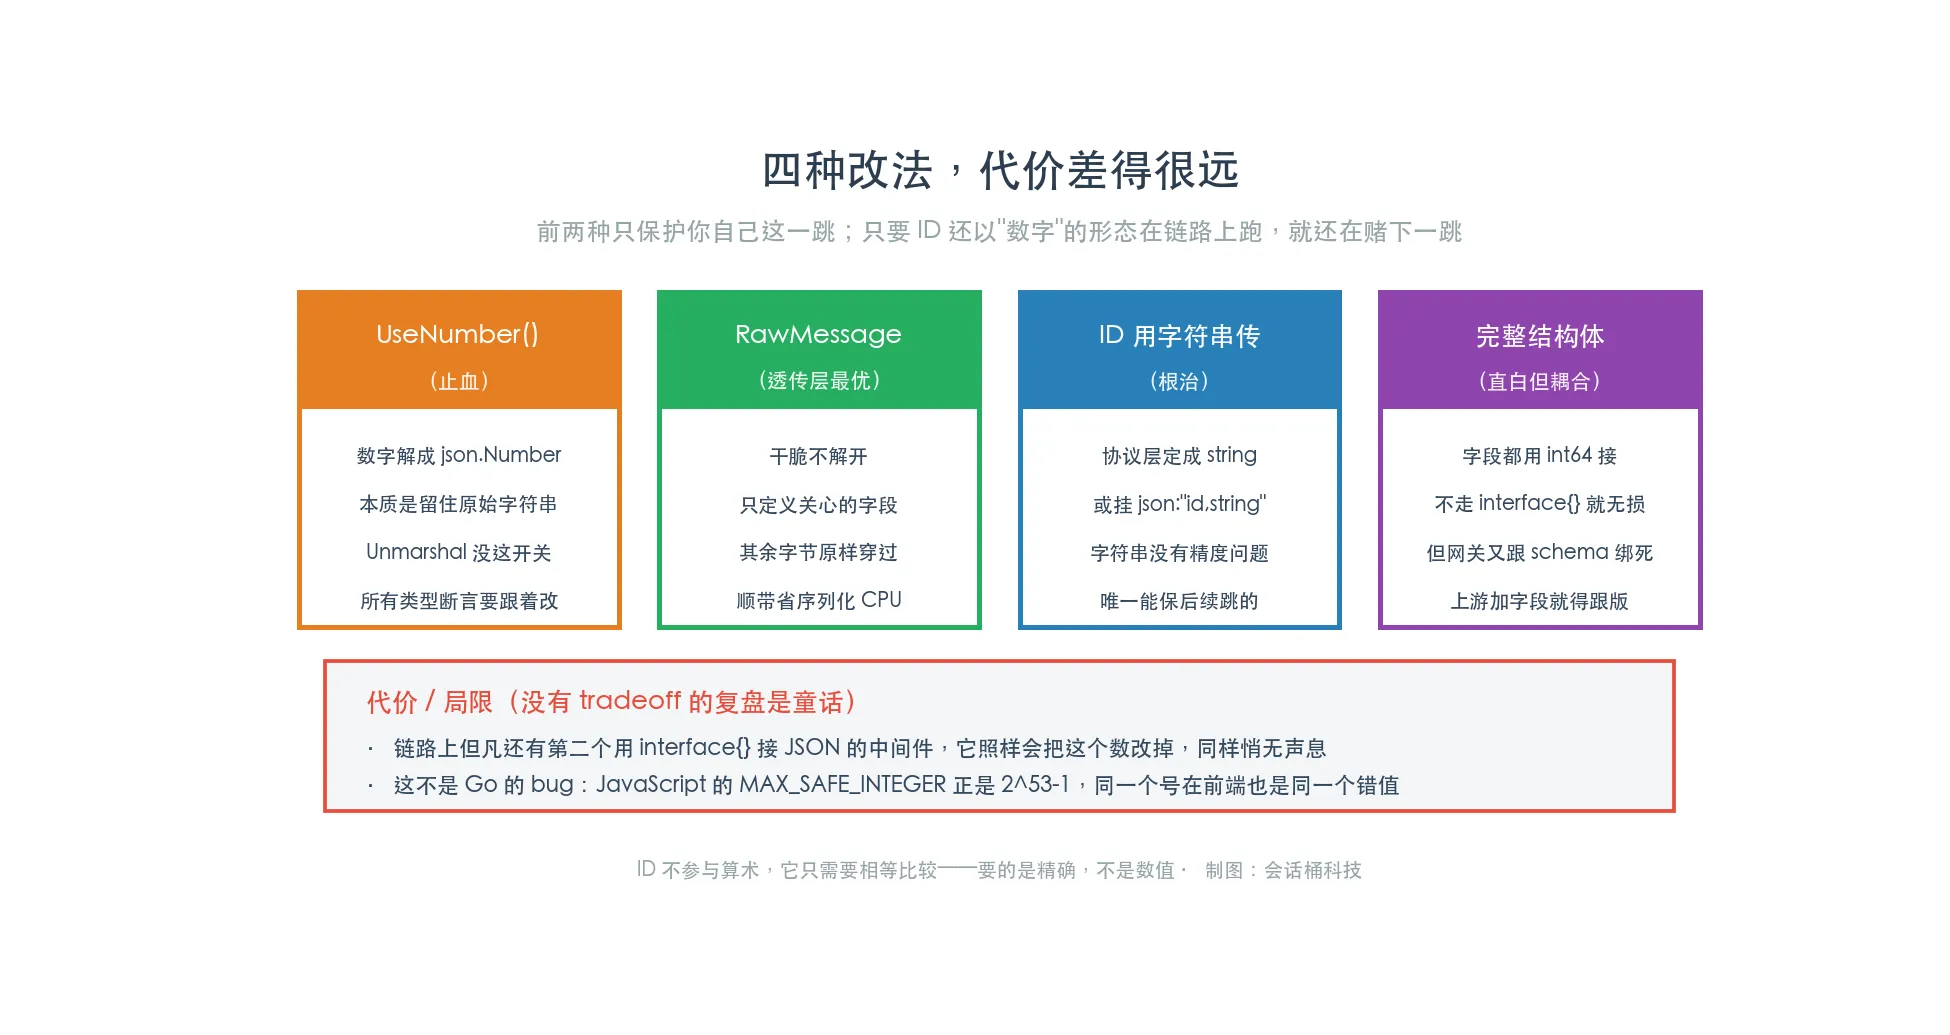
代价必须说清楚,没有 tradeoff 的复盘是童话: 前两种改法只保护了你自己这一跳。链路上但凡还有第二个用 interface{} 接 JSON 的中间件——另一个网关、一段 MQ 消费逻辑、一个日志采集器、一个前端页面——它照样会把这个数改掉,而且同样悄无声息。只要 ID 还是以“数字”的形态在链路上跑,你就永远在赌下一跳有没有踩这个坑。
所以真要根治,只有第 ③ 条。
五、一条可以带走的经验
如果这场事故只留一句,我想留这句:
ID 不是数字,它只是长得像数字。
判断一个东西该不该用数字类型存,标准很简单:你会不会对它做算术? 订单号不会相加,用户 ID 不会求平均,身份证号不会做减法——它们唯一的操作是“比较是否相等”。这类东西的学名叫标识符,它要的是精确,不是数值。而浮点数这种类型,从设计之初交付的就是“近似”——用一个承诺近似的类型,去装一个要求精确的值,出事只是时间问题。
再往深一层,这事给我立了另一条规矩:任何“透传”,都不是真的透传。
只要你把字节解成了内存里的类型、再编码回字节,中间就发生了一次翻译。而翻译一定有损——不是这次,就是下次;不是这个字段,就是那个字段。真正的透传只有一种,就是不解开。
写代码的时候,我们太容易把 json.Unmarshal 当成一个“零成本的格式转换”,好像它只是换了个马甲、内容还是那个内容。但它不是。它是一次从无类型的文本世界,到有类型的内存世界的强制翻译。而 JSON 这一侧的类型系统,比 Go 那一侧粗糙得多——一个 number 要同时扛下整数、小数、大数、负数。当粗的一侧往细的一侧翻的时候,Go 能补上信息(你给它 int64,它就照 int64 装);可当你交出去的是 interface{},你就等于告诉它:我不知道这是什么,你自己看着办。
于是它按规范选了 float64。
它没有做错任何事。做错事的是那句“我不知道”。
事故机理均真实可复现(Go 1.26 实测),叙述为便于阅读做了合并与简化。