8 个 goroutine 各写各的计数器,没有锁,比单线程慢 13 倍
八个 goroutine,每个只写自己那一格,互不重叠,没有锁,没有 channel,
-race跑出来干干净净。它比一个 goroutine 从头干到尾慢十三倍。
先把结论摆在最前面,省得你往下翻:
总累加次数 8000 万

单线程,1 个变量        166ms
8 个 goroutine 分片    2.264s     ← 慢 13.7 倍
八个 goroutine,每个只写自己那一格,互不重叠,没有锁,没有 channel,-race 跑出来干干净净。它比一个 goroutine 从头干到尾慢十三倍。
这段代码我贴在下面,你先看一眼,看看能不能挑出毛病。
一、那段“正确的优化”
事情的起点是一个再普通不过的需求:网关要统计请求数。
最早的写法就是一个全局计数器:
var reqCount int64

func handle(w http.ResponseWriter, r *http.Request) {
    atomic.AddInt64(&reqCount, 1)
    // ...
}
压测压到高并发的时候,这个计数器成了热点。原因很好理解:所有核都在抢同一个 int64,抢的核越多,越慢。
这里得先澄清一个很容易混的词,不然后面全串味:
atomic 是无锁(lock-free)的。 它没有互斥量,不会让 goroutine 挂起,不进调度器。这一点没有争议。
但无锁不等于无争用。 要原子地改一个变量,执行的那个核必须先独占这个变量所在的缓存行——独占了才敢改,不然两个核同时改就乱了。多个核同时想独占同一行,硬件就得排队:amd64 上 atomic.AddInt64 编译出来是 LOCK XADDQ,arm64 上是 LDADDAL(或老架构的 LDXR/STXR 循环重试)。LOCK 这个前缀锁的不是操作系统的锁,锁的是缓存行。
所以下文所有的“争用”,指的都是这个硬件层的、抢缓存行独占权的争用,跟 sync.Mutex 一点关系没有。这句话是后面整篇的伏笔。
解法是教科书级的,任何一本讲高并发的书都会写:分片。既然大家抢同一个变量会打架,那就一人发一个,各写各的,读的时候求和。
const shards = 8

type Metrics struct {
    reqCount [shards]int64
}

func (m *Metrics) Inc(shard int) {
    atomic.AddInt64(&m.reqCount[shard], 1)
}

func (m *Metrics) Total() int64 {
    var sum int64
    for i := range m.reqCount {
        sum += atomic.LoadInt64(&m.reqCount[i])
    }
    return sum
}
这段代码放进 code review,不会有任何人拦。它不是“能用”,它是对的——分片消除热点争用是标准手法,Go 运行时自己到处在用这个思路(sync.Pool 给每个 P 一份本地缓存,就是这个套路)。
然后压测结果出来了:QPS 不但没涨,还掉了一大截。
二、我当时排查的顺序(这段全是弯路)
第一反应:分片数选得不对。
8 个分片,机器 14 核,是不是分片太少了还在抢?调到 16、32、64。没用,一点没变。往下调到 4、2,也没用。
第二反应:goroutine 调度问题。
是不是 goroutine 全被排到了同一个 P 上,压根没并行?打印 GOMAXPROCS,14,正常。加了埋点确认八个 goroutine 确实在同时跑。不是调度。
第三反应:atomic 本身慢,换个写法。
把 atomic.AddInt64 换成 sync.Mutex 保护的普通加法。更慢了(这个倒是符合预期)。换成 sync/atomic 的 Int64 类型,一样慢。
第四反应:是不是有 race 我没看见?
go run -race。干净。 一条警告都没有。
这一步之后我开始觉得不对劲了。因为按我原本的猜测——总得有什么东西在竞争吧——那 race detector 至少该有点反应。它没有,因为确实没有数据竞争:每个 goroutine 只碰自己那个下标,而且用的是原子操作。从 Go 的内存模型看,这段代码完美无瑕。
第五反应:上 pprof。
CPU profile 出来,时间几乎全堆在 atomic.AddInt64 那一行。
这个结果毫无信息量。我知道时间花在那儿,问题是那一行代码没有任何毛病。profile 能告诉你“哪里慢”,但当“哪里”是一条本身完全正确的指令时,它就到头了。
到这一步,所有软件层面的怀疑对象都排查完了:不是逻辑错、不是锁、不是调度、不是 race、不是 GC。代码是对的,profile 指着一行对的代码说它慢。
三、剥到最小复现
我把业务全剥掉,只留骨架:N 个 goroutine,每个对一个 int64 做原子累加,跑一千万次。
然后我做了一件事——不改代码,只改这几个 int64 在内存里隔多远。
用一块手动对齐到 4096 边界的裸内存,按指定间距摆 8 个 int64,八个 goroutine 各认一个。除了间距,其他一模一样:
func (a *arena) slot(i int, stride uintptr) *int64 {
    return (*int64)(unsafe.Pointer(a.base + uintptr(i)*stride))
}
结果是这样的:
【8 个 goroutine 各写各的分片,唯一变量=分片间距】

分片间距      耗时       相对最快    结果校验
8 字节      2.407s    122.46x    ✓
16 字节     852ms      43.36x    ✓
32 字节     265ms      13.47x    ✓
64 字节     36ms        1.81x    ✓
128 字节    20ms        1.00x    ✓
256 字节    20ms        1.00x    ✓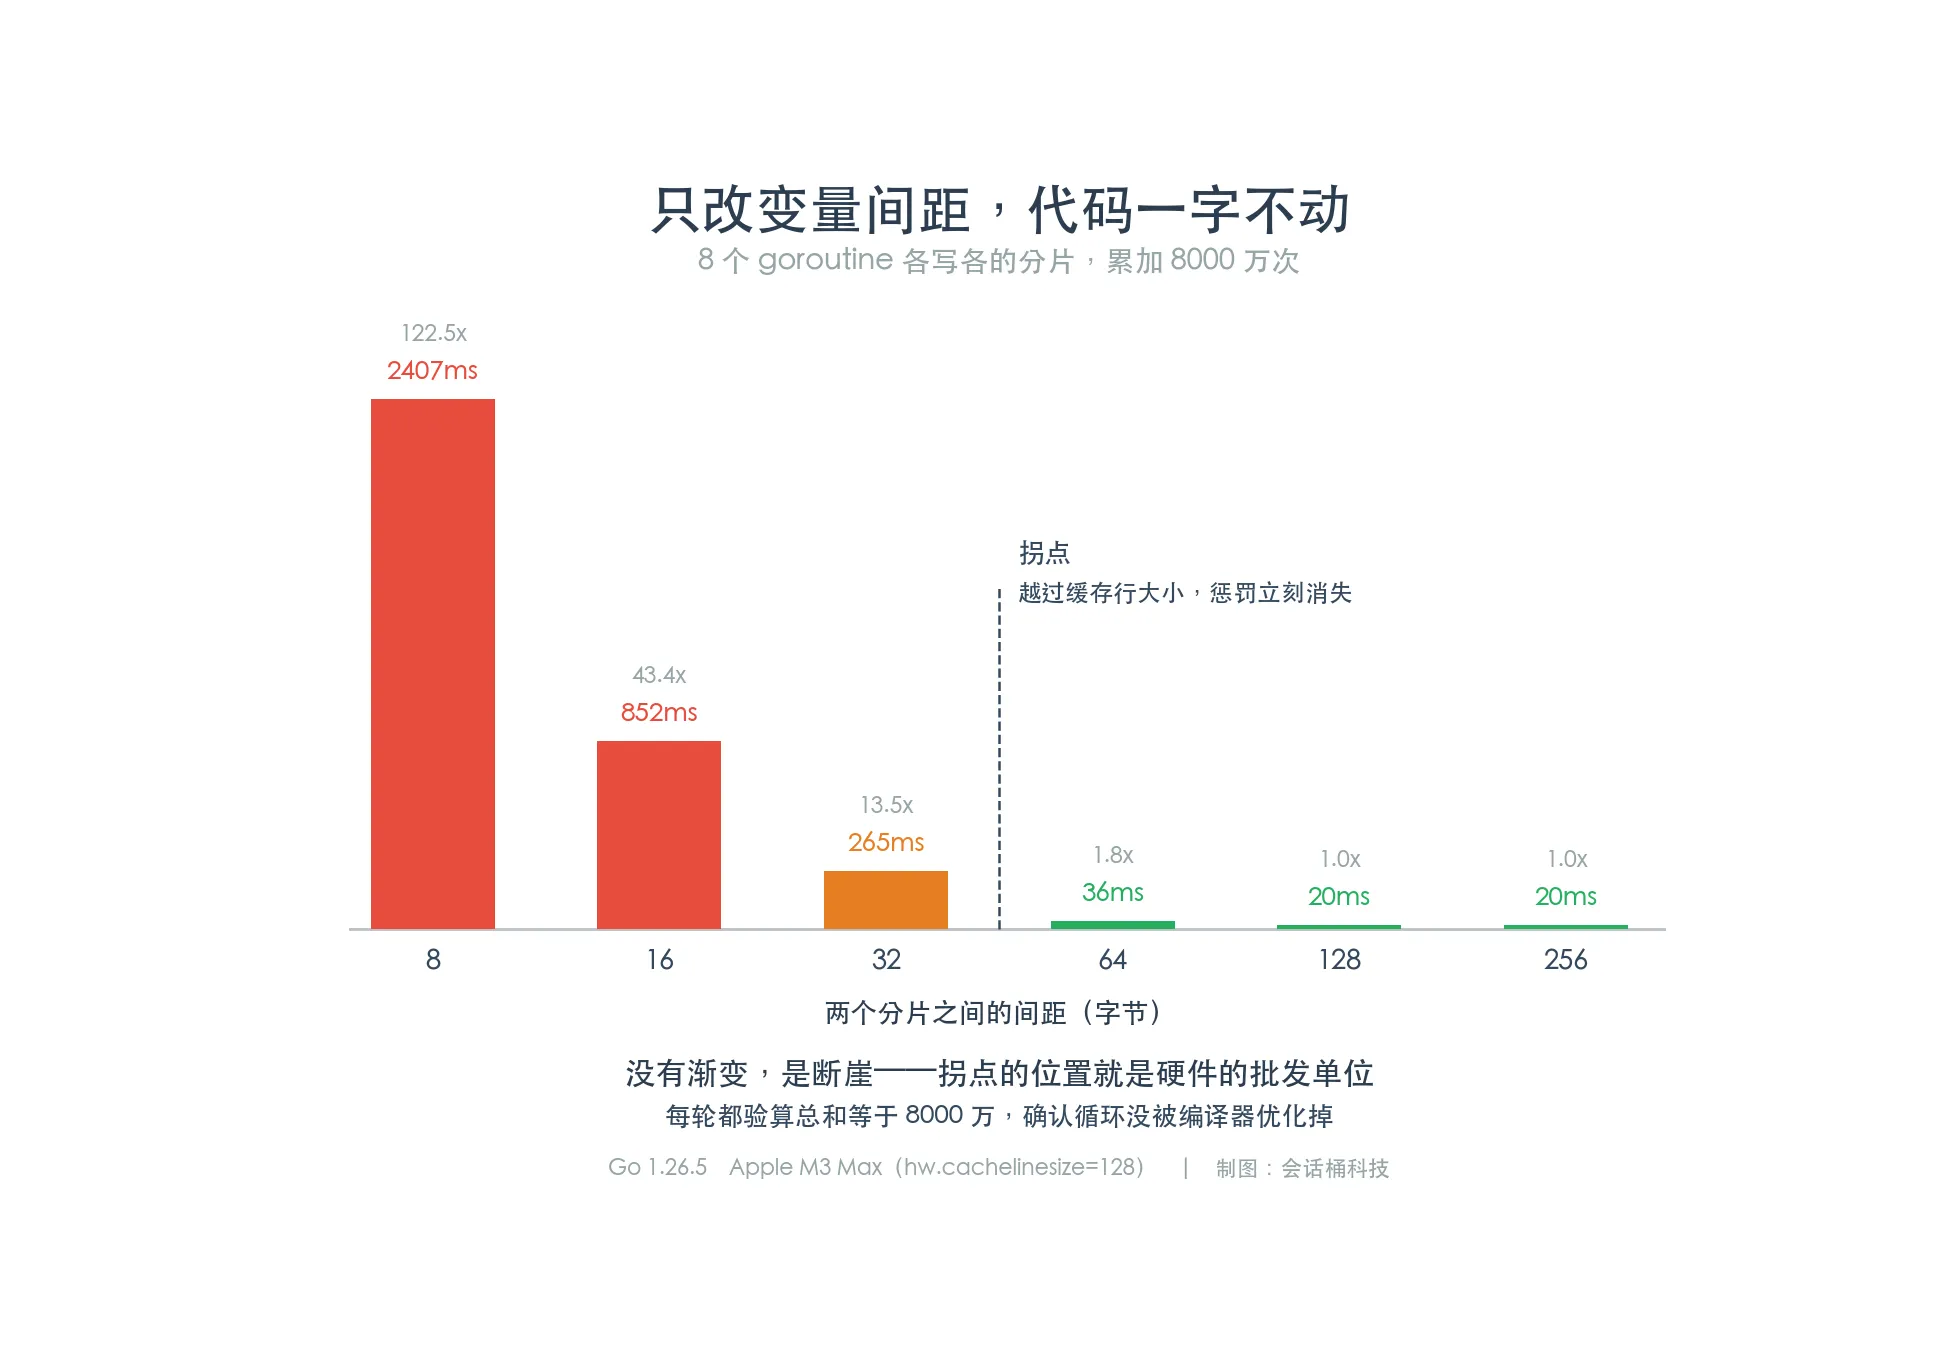
同样的代码,同样的指令条数,同样的 goroutine 数,只因为八个变量在内存里挨得近,慢了 122 倍。
(最后那列“结果校验”是我特意加的:每轮结束都验算总和等于 8000 万,确认循环没被编译器优化掉、也没丢数据。全部 ✓。这条后面还要用。)
这时候方向就清楚了:问题不在我写的任何一行代码里。它在这些数据躺在哪儿。
四、根因:CPU 眼里没有“变量”,只有“行”
要讲清楚这件事,得下到缓存那一层。
第一步:CPU 不按字节读内存,按“行”批发
CPU 和内存之间隔着 L1/L2/L3 缓存。缓存跟内存交易的最小单位叫缓存行(cache line)——x86 上通常 64 字节,ARM64 上 128 字节。
你读一个 8 字节的 int64,硬件实际搬进缓存的是包含它的整整一行。
这个设计没什么好指责的,跟虚拟内存按 4KB 的“页”来管是同一个思路:管理粒度太细,管理本身的开销就会超过收益。内存体系的每一层都在批发,没有一层做零售。
第二步:多核各有各的 L1,一个核改了,别人手上的副本就得作废
核心 1 和核心 2 可以各自缓存同一块内存的副本。核 1 一写,核 2 手上那份立刻成了过期数据,必须作废、重新去下一级取回来。这套机制叫缓存一致性协议(MESI 及其变种)。
到这里为止,一切都是必要且正确的。
第三步:问题在这里——作废的粒度是“整行”,不是“变量”
硬件不知道你的变量边界在哪。它不认识 reqCount[0] 和 reqCount[1],它只认行号。
[8]int64 一共 64 字节,八个分片全部落在同一个缓存行里。于是:
核1 改 reqCount[0]
  → 核2 缓存里那一整行作废(连它压根不碰的 [1] 一起)
核2 要改 reqCount[1]
  → 缓存未命中,重新取回整行
  → 核1 那一行同时作废
核1 又要改 reqCount[0]
  → 缓存未命中,重新取……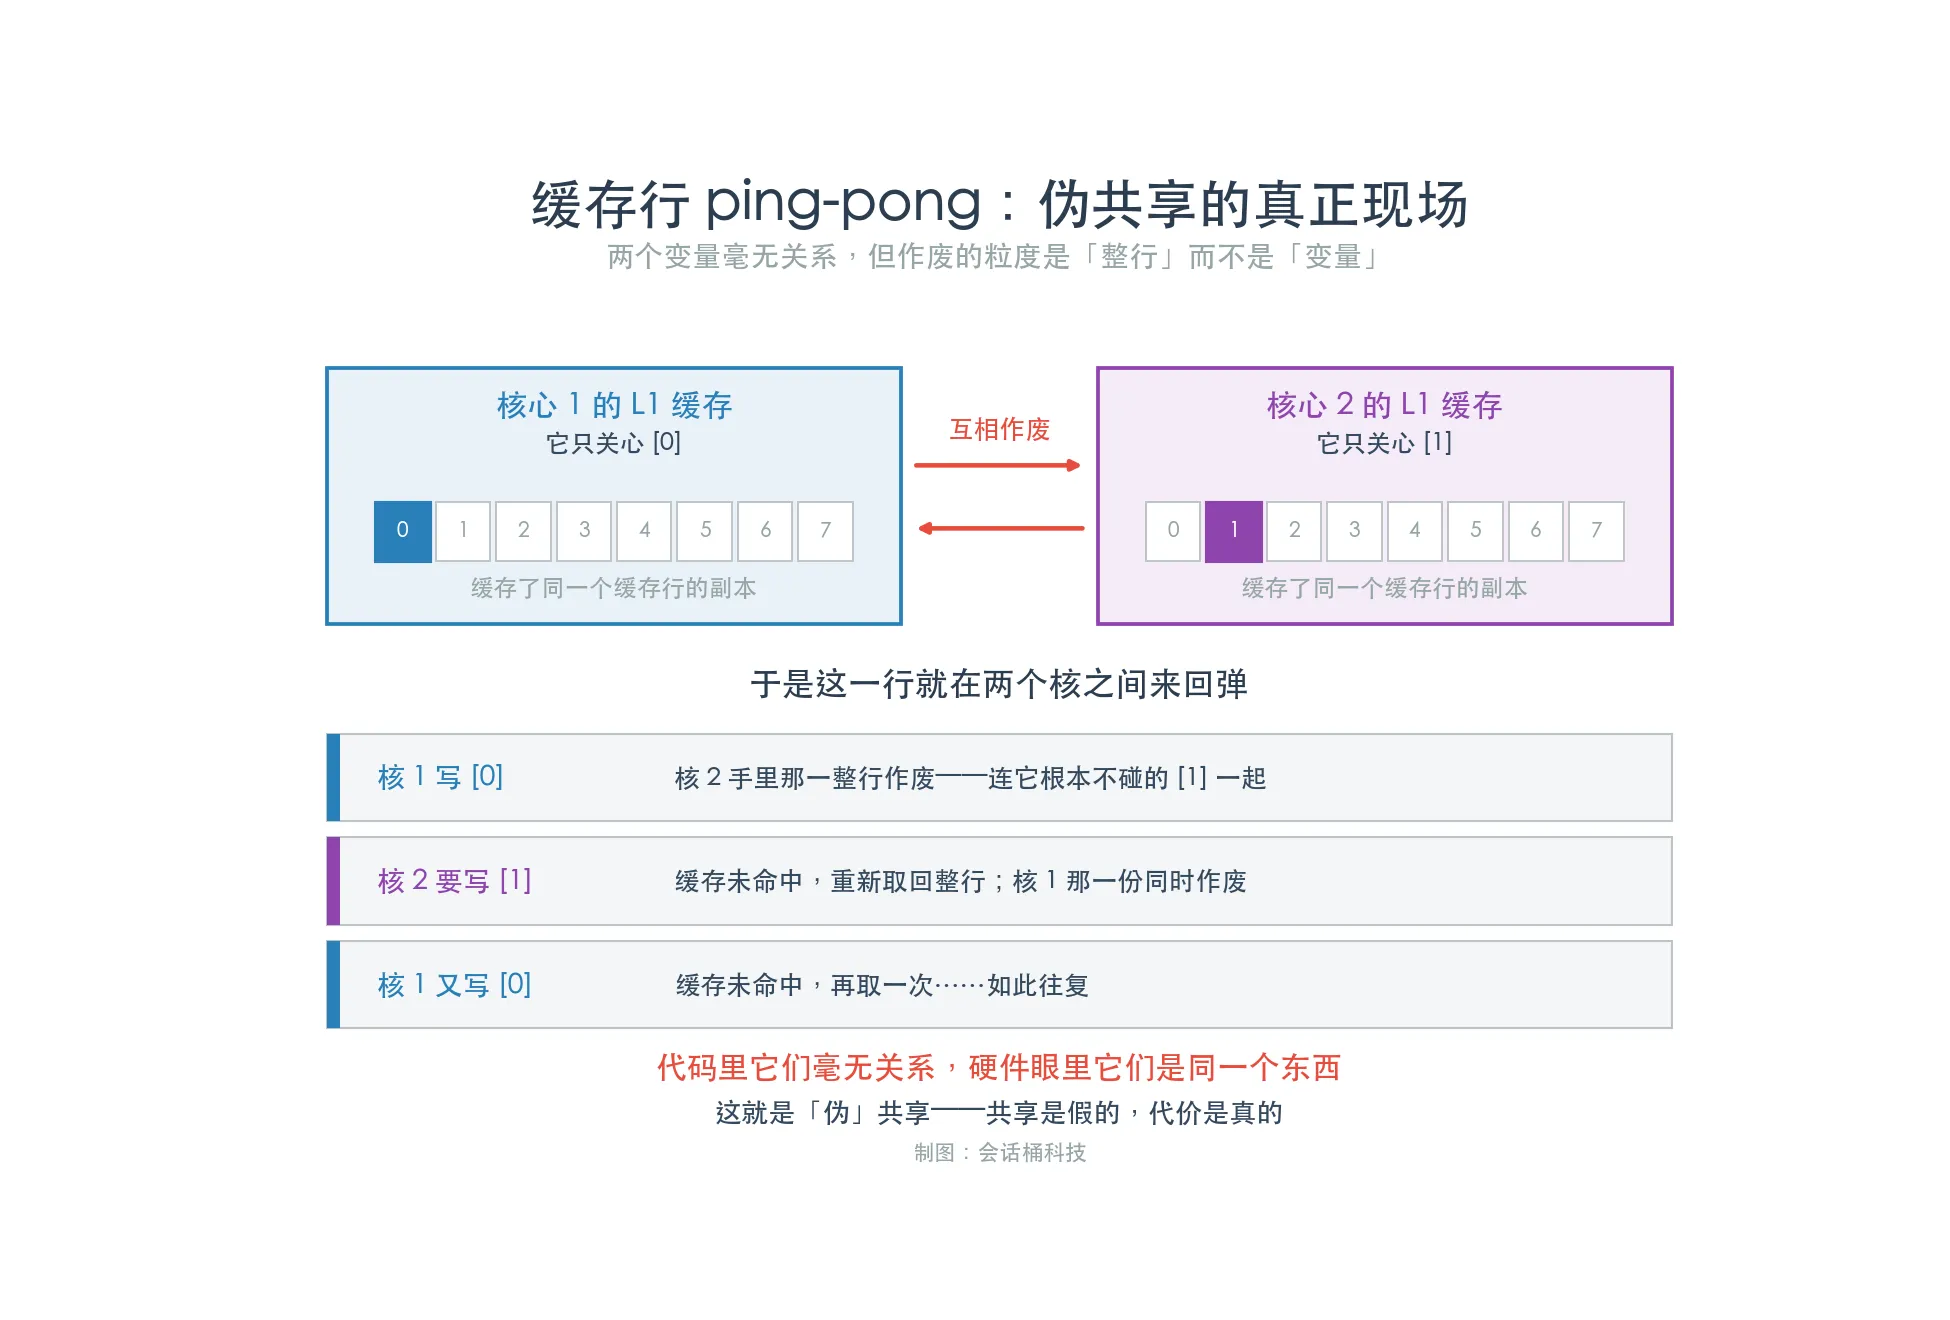
这一行缓存就在八个核之间来回弹,学名叫 cache line ping-pong。八个核谁也别想把它安安稳稳留在自己的 L1 里。
这就是“伪共享”(false sharing)名字的由来:在你的代码里,这八个变量毫无关系,八个 goroutine 零交集,共享根本不存在;但在硬件那一层,它们是同一个东西。
共享是假的,代价是真的。
五、防杠环节:怎么证明这真的是伪共享
写到这儿我知道会有人说:你这不就是 atomic 争用吗,跟缓存行有什么关系。
所以我补了一组四档对照,两个执行流做同样多的累加(各一千万次,总量固定):
单线程(1 个 goroutine 跑完全部)    35ms   ✓
真共享(2 个 goroutine 抢同一变量)   74ms   ✓
伪共享(相邻 2 变量,隔 8 字节)      70ms   ✓
无共享(2 变量隔 128 字节)          18ms   ✓

伪共享 / 无共享 = 3.87x
伪共享 / 真共享 = 0.94x
伪共享 / 单线程 = 2.00x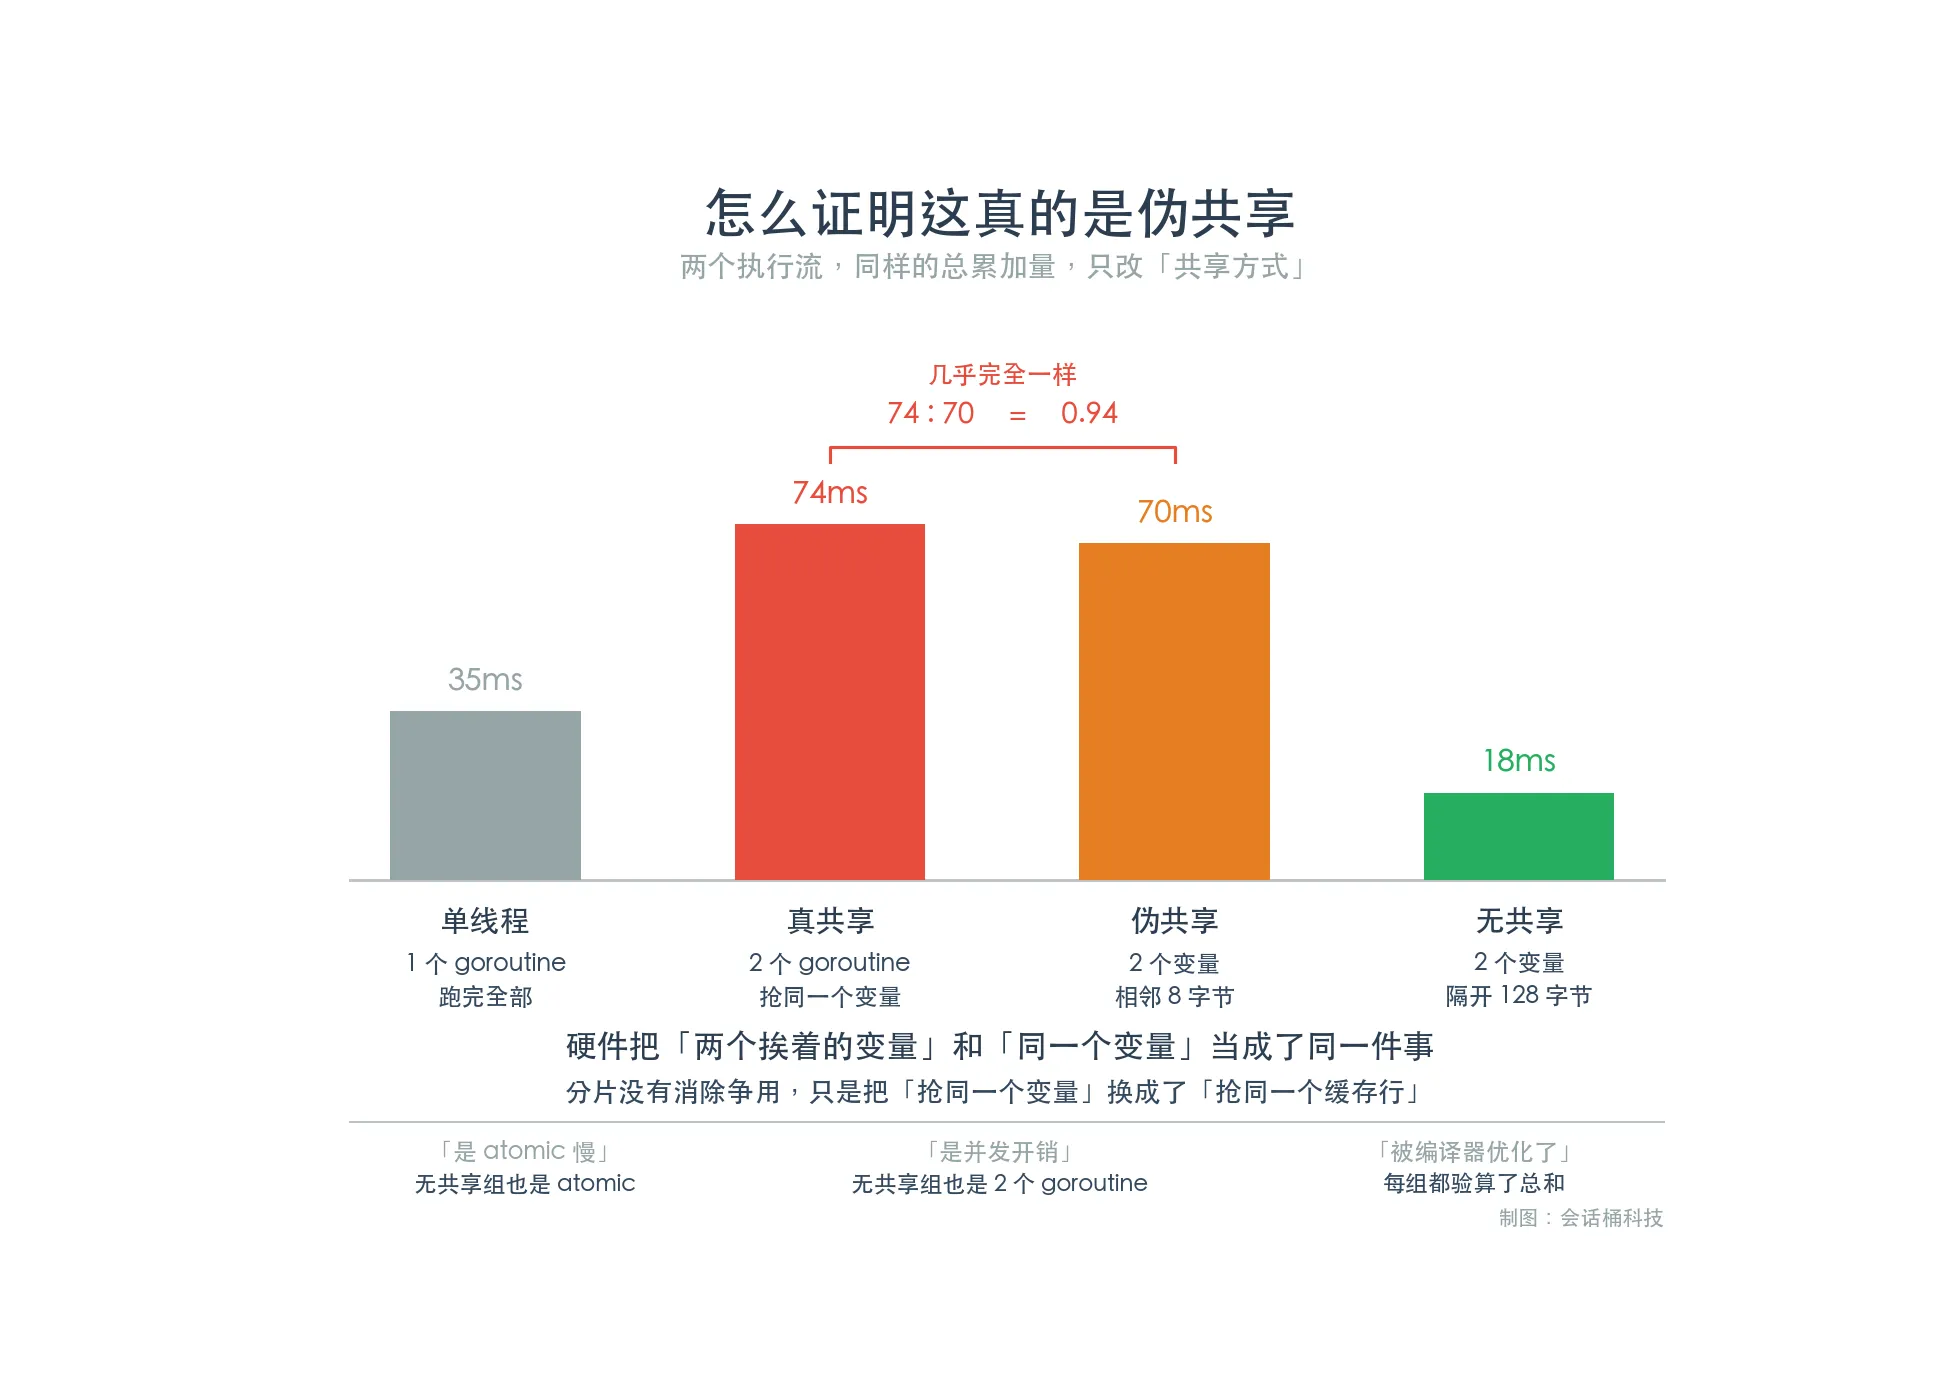
请重点看中间两行:
伪共享 70ms,真共享 74ms。比值 0.94——两者几乎完全一样。
“真共享”是两个 goroutine 死抢同一个变量,那是货真价实的争用。“伪共享”是两个互不相干的变量,只是恰好挨着。
硬件把它们当成了同一件事。
回到开头那个伏笔。争用从来就发生在硬件层,抢的从来就是缓存行的独占权——atomic 无锁,但要改一个变量,得先独占它所在的那一行。
所以分片到底干了什么?它把“八个核抢同一个变量”换成了“八个核抢同一个缓存行”。
而硬件根本不区分这两件事。 你以为把争用消除了,其实只是换了个抢法,一点没少。这也正是上面那两个数字为什么会几乎相等。
再看第一行和第三行:伪共享 70ms,单线程 35ms——多用一个核,慢了整整一倍。 这就是标题里那个 13.7 倍的小号版本。
而最后一行给出了对照的另一端:同样是两个 goroutine、同样是 atomic,只要把变量隔开 128 字节,18ms,相对单线程接近两倍的正常并行加速。
三条路堵死了:
- “是 atomic 慢” —— 无共享那组用的也是 atomic,18ms。
- “是并发开销” —— 无共享那组也是两个 goroutine,18ms。
- “是编译器优化掉了快的那组” —— 每组都验算了最终总和,全部等于预期值。真跑了那么多次。
唯一的变量只剩一个:这两个 int64 在内存里隔多远。
六、改法,以及它的代价
改法本身很蠢:把每个分片撑大到独占一个缓存行。
const shards = 8

type Metrics struct {
    reqCount [shards]struct {
        v    int64
        _pad [120]byte   // 补到 128 字节
    }
}

func (m *Metrics) Inc(shard int) {
    atomic.AddInt64(&m.reqCount[shard].v, 1)
}
那 120 字节什么也不干,就是占地方,把下一个分片挤到下一个缓存行去。
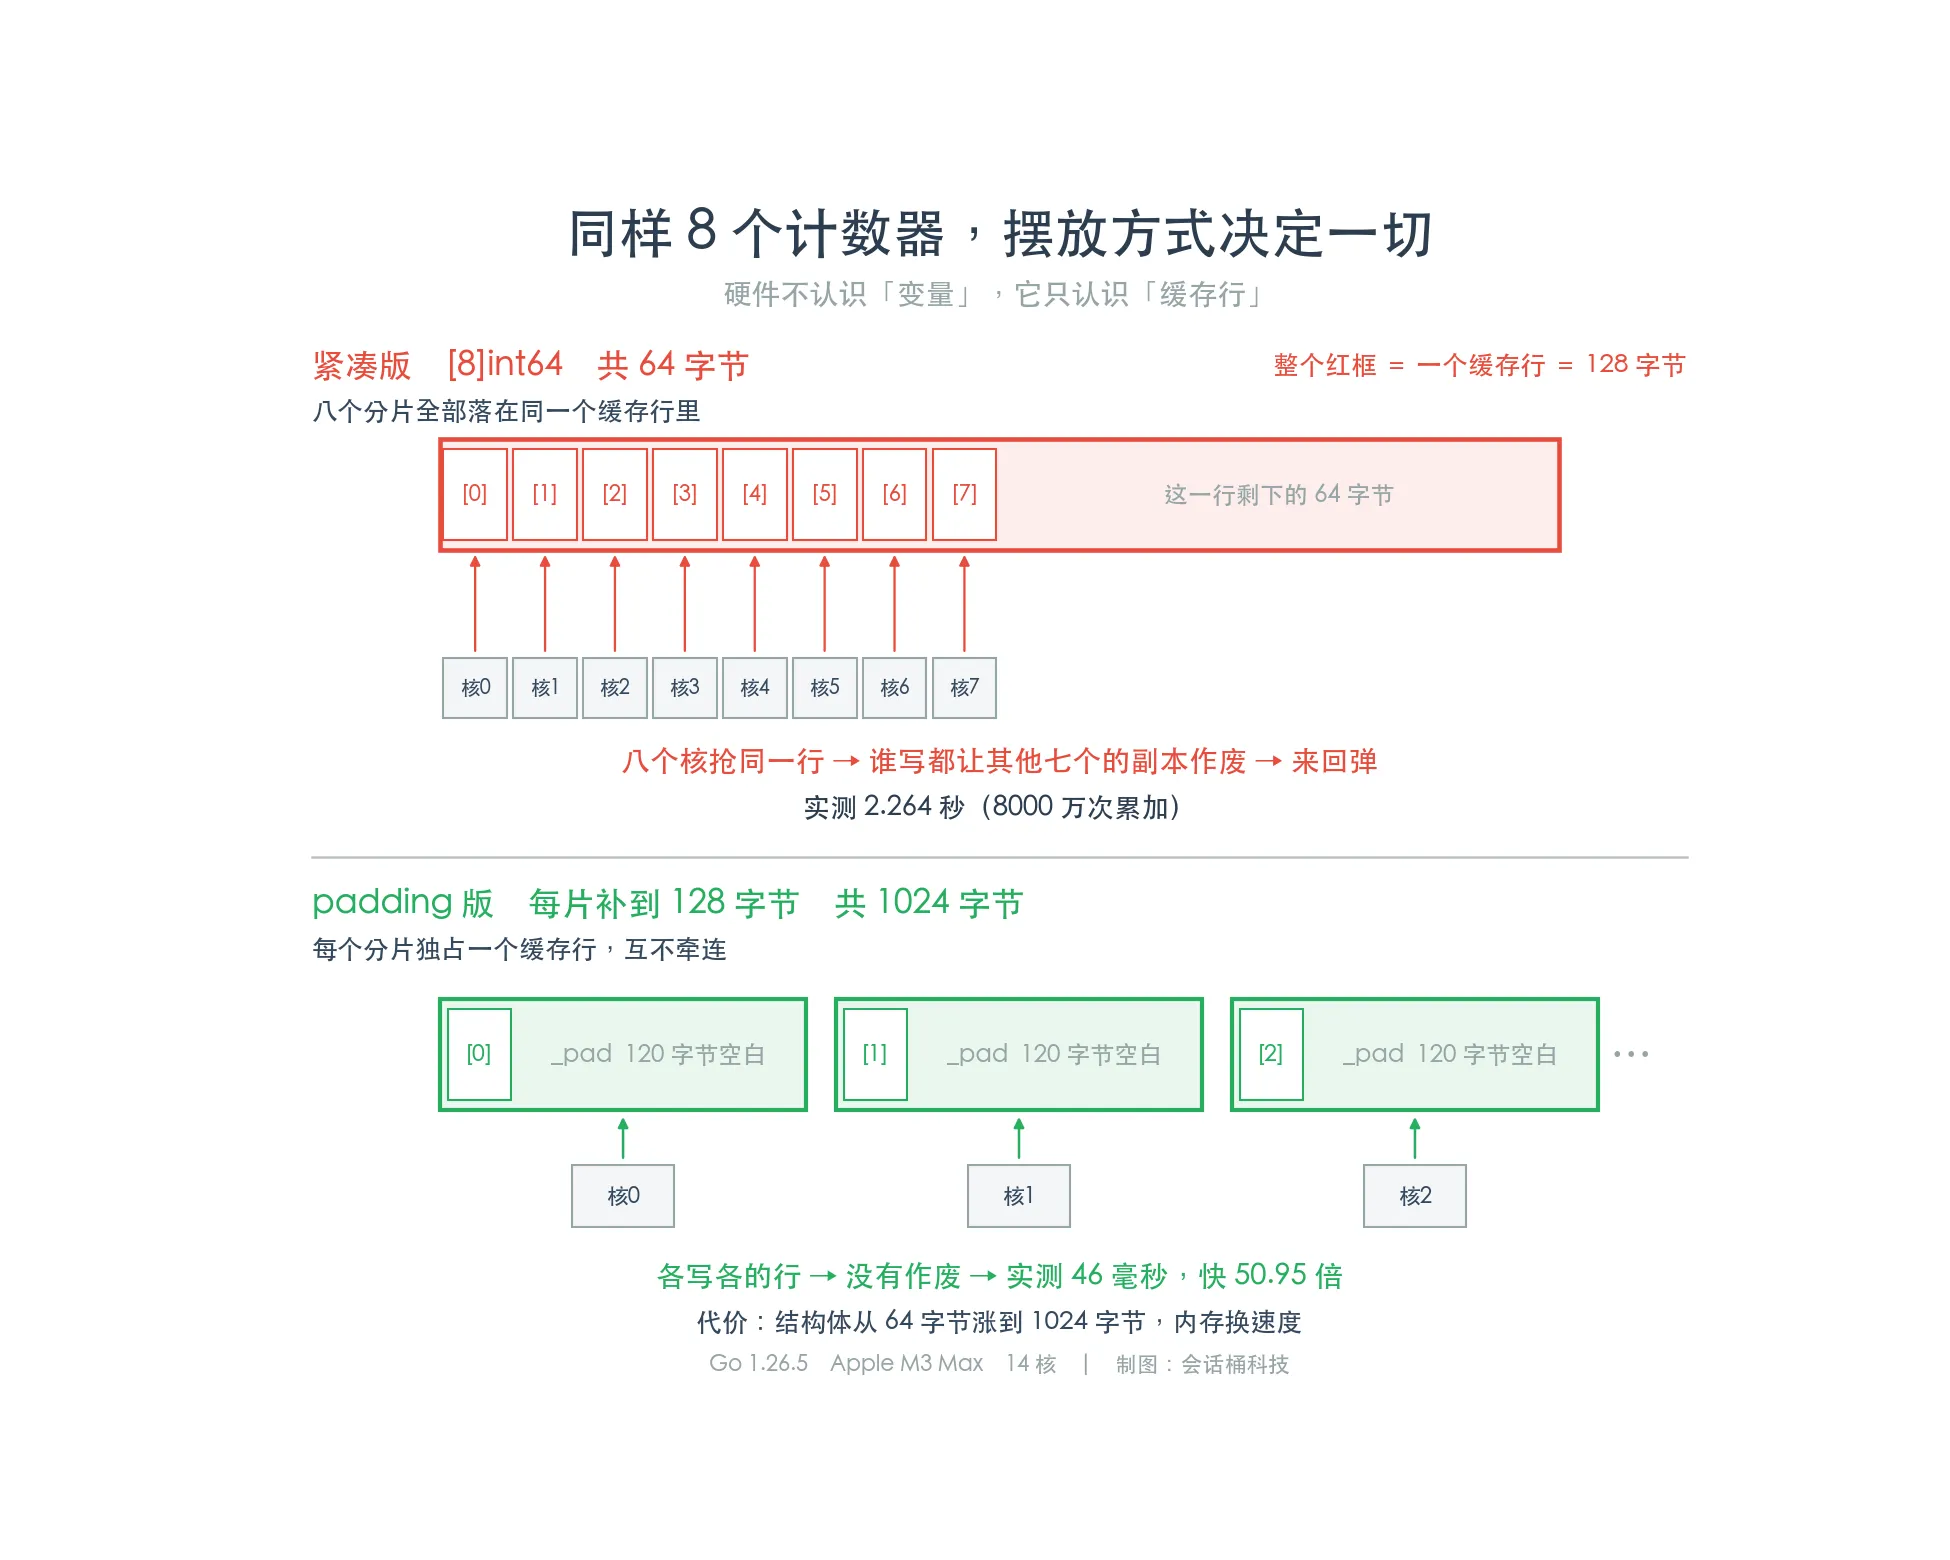
紧凑 [8]int64(64 字节)        2.327s   ✓
padding 到 128(1024 字节)      46ms    ✓

加了 960 字节空白,快了 50.95 倍
代价是内存:结构体从 64 字节变成 1024 字节,16 倍。
这是个非常直白的空间换时间。八个计数器多花不到 1KB,无所谓;但如果你要做的是每个连接一个分片、十万个连接,那就是 100MB 换 6.4MB,得算账了。
为什么是 128 不是 64
回头看间距扫描那张表,有个细节我一开始忽略了:64 字节那档还剩 1.81x 的惩罚,128 字节才彻底干净。
但在两个 goroutine 的对照实验里,隔开 64 字节就已经满血了。
这两个结果不矛盾,它指向的是这台机器的缓存层次。我查了系统报的值:
$ sysctl hw.cachelinesize
hw.cachelinesize: 128
而 Go 运行时内部(internal/cpu/)为每个架构维护着一张缓存行大小表:
cpu_x86.go       CacheLinePadSize = 64
cpu_arm64.go     CacheLinePadSize = 128
cpu_ppc64x.go    CacheLinePadSize = 128
cpu_s390x.go     CacheLinePadSize = 256
cpu_riscv64.go   CacheLinePadSize = 64
cpu_mips.go      CacheLinePadSize = 32
最合理的解释是:这台机器 L1 的行是 64 字节(所以两个核、隔 64 就够),而更外层缓存和一致性的粒度是 128(所以八个核同时上,隔 64 仍有残留争用,隔 128 才干净)。保守取大的那个值,是对的。
顺带说一句:一个语言的运行时专门为每种 CPU 架构记录这个常量——这本身就说明伪共享不是什么边角料奇技淫巧,它真实到必须写进语言的地基里。
标准库自己就在干这件事
如果你觉得手写 padding 太土,可以去看 $GOROOT/src/sync/pool.go 第 73 行:
type poolLocal struct {
	poolLocalInternal

	// Prevents false sharing on widespread platforms with
	// 128 mod (cache line size) = 0 .
	pad [128 - unsafe.Sizeof(poolLocalInternal{})%128]byte
}
注释直接写着 Prevents false sharing,padding 到 128 字节。
sync.Pool 是 Go 里被用得最狠的对象池之一,它给每个 P 一份本地缓存——这正是“分片”思路。而标准库的作者非常清楚,分片如果不 padding,等于白分。
你手写的那 120 字节空白,跟标准库是同一个动作。
还有别的路吗
- 减少写的频率:goroutine 内部先在局部变量里累加,退出前或者每隔一段时间才写回共享分片一次。写得少了,ping-pong 自然就少。这往往比 padding 更划算,因为不额外吃内存。
- 换数据结构:真的需要高频精确计数,考虑每个 goroutine 完全独立的局部计数 + 定期汇总,而不是共享一个数组。
- 别过早分片:如果计数器本来就不是热点,一个
atomic.AddInt64挺好。这次事故的起点,就是一个不必要的优化。
七、可迁移的那一句
这次踩坑之后,我记住的是这句:
有一整类性能问题,原因不在你写了什么,而在你的数据躺在哪儿。
再收紧一点,是这个:
并行的前提是“真的不共享”,而“不共享”的判定标准不在你的代码里,它在硬件的批发单位上。
你在代码里画的那条边界——这是 [0],那是 [1],两个 goroutine 各管各的——在编译器眼里成立,在 Go 内存模型眼里成立,在 race detector 眼里也成立。但它在缓存那一层不成立,因为那一层根本不认识“变量”这个概念。
这也是为什么这个坑能干干净净地通过 code review:review 检查的是逻辑,而这个 bug 不在逻辑里。
最后留一个可以立刻自查的:如果你的代码里有下面这类东西,都值得量一量——
- 按 goroutine / 按 worker / 按分片切开的计数器、统计量数组
- 一个结构体里,多个字段被不同 goroutine 高频写入
[]struct{...}数组里每个元素被一个独立 goroutine 持有并频繁更新
它们有个共同长相:逻辑上完全独立,物理上紧挨着。
附:实验环境与复现
文中所有数字都是实跑出来的,不是抄来的经验值。环境:
Go 1.26.5   darwin/arm64
Apple M3 Max,14 核(GOMAXPROCS=14)
sysctl hw.cachelinesize = 128
三点说明,免得数字被误读:
- 绝对数值跟机器强相关。 换一台 x86、换核数、换 Go 版本,倍数都会变。但“挨着就慢、隔开就快、拐点落在缓存行大小上”这个结构是稳定的——想验证的话,跑一遍上面的间距扫描,看看你机器上的拐点在哪。
- 每一组都做了结果校验,最终总和必须等于预期累加次数,确保没有被编译器优化掉、没有丢更新。
- 间距扫描用的是手动对齐到 4096 边界的裸内存,用
stride控制间距,保证“间距”是唯一变量,排除内存分配器的对齐差异干扰。